Qwen-Image-2.1-Turbo

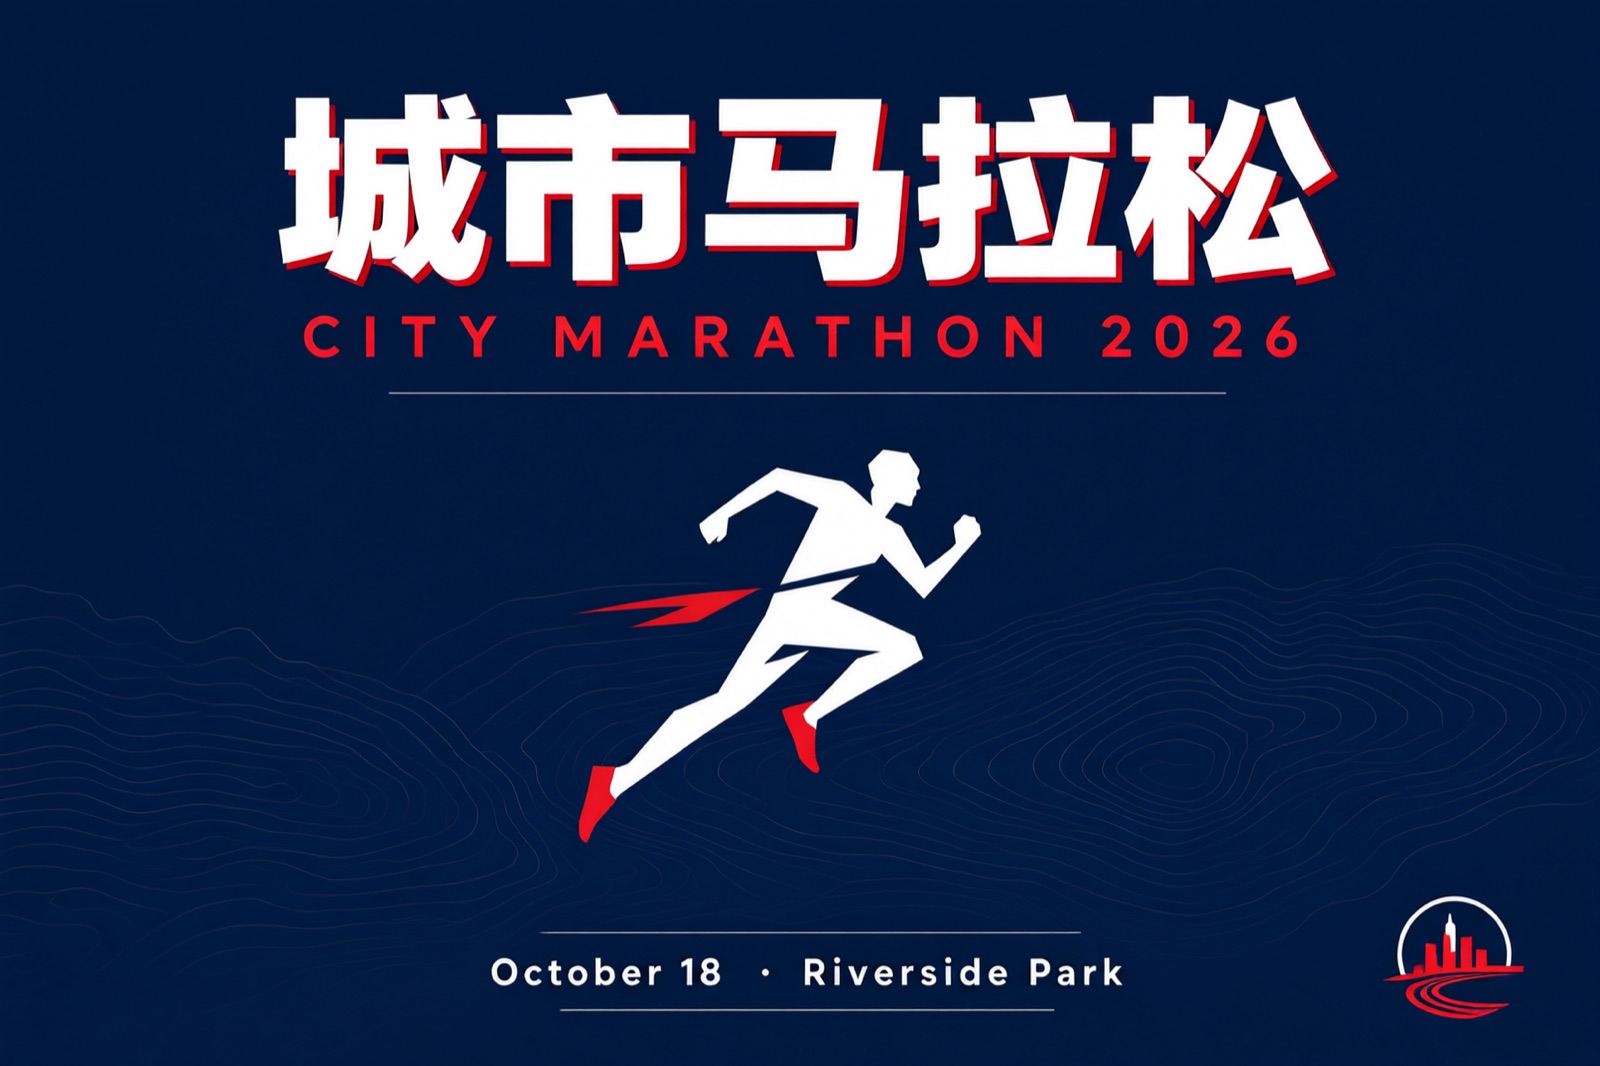
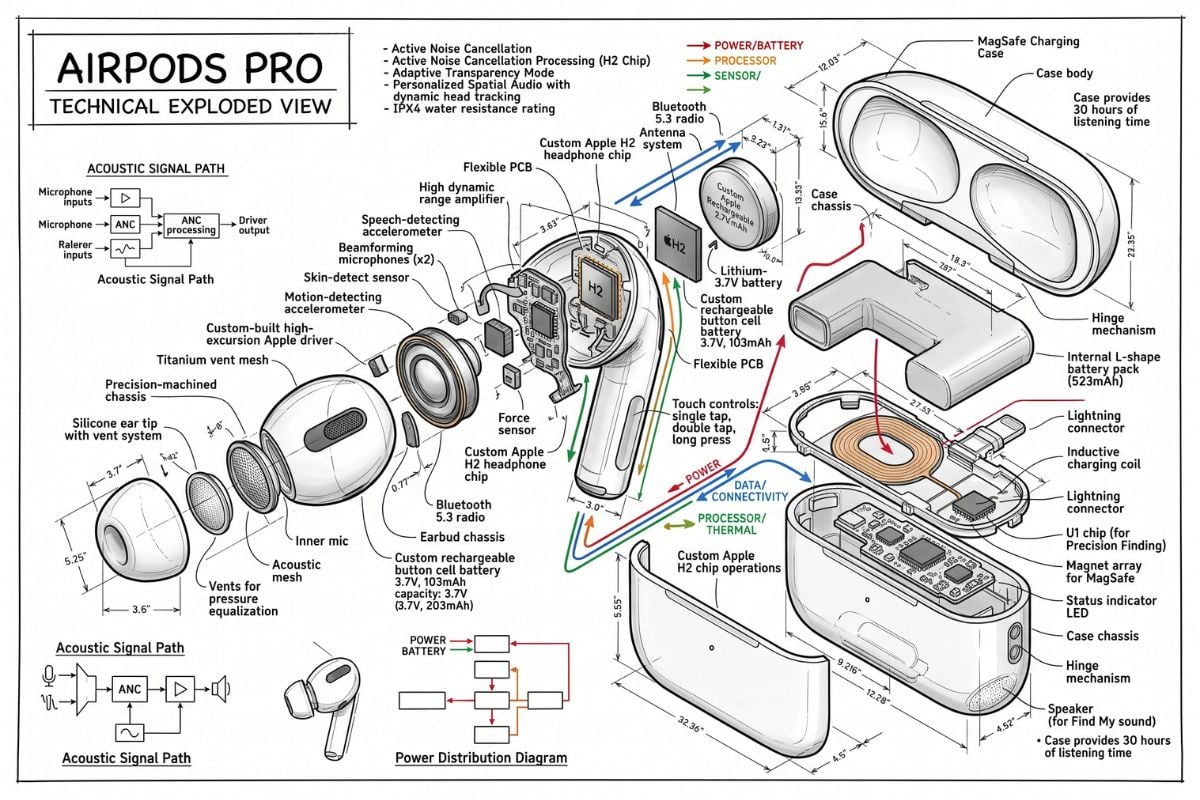
Qwen-Image-2.1-Turbo est la version en 8 étapes de Qwen-Image-2.1, publiée par l'équipe Qwen le 9 octobre 2026. Elle conserve la même architecture de génération visuelle de 7B et le même pipeline pour le texte-vers-image et l'édition, mais échantillonne en 8 étapes de débruitage au lieu des 40 par défaut du modèle de base. GoEnhance ne propose pas Turbo : la console ci-dessous exécute Qwen Image 3, le modèle Qwen le plus récent disponible ici.
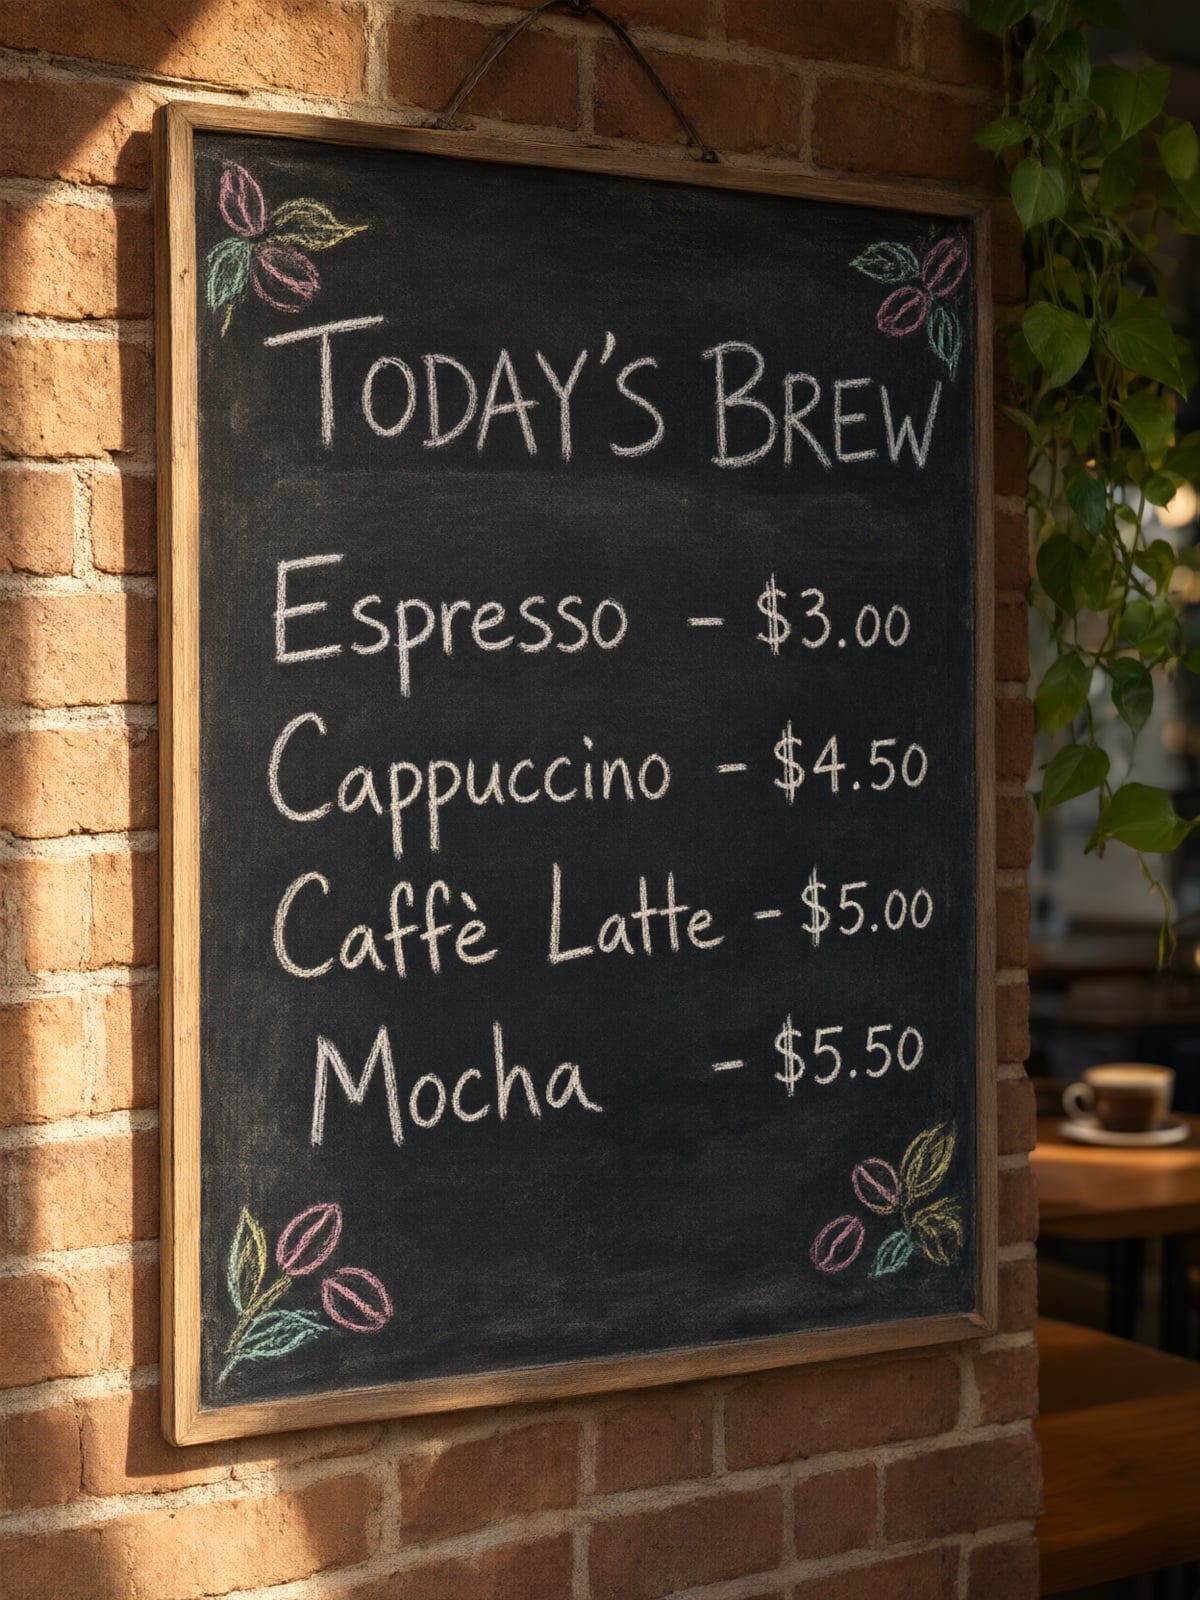
Menu de café sur ardoise
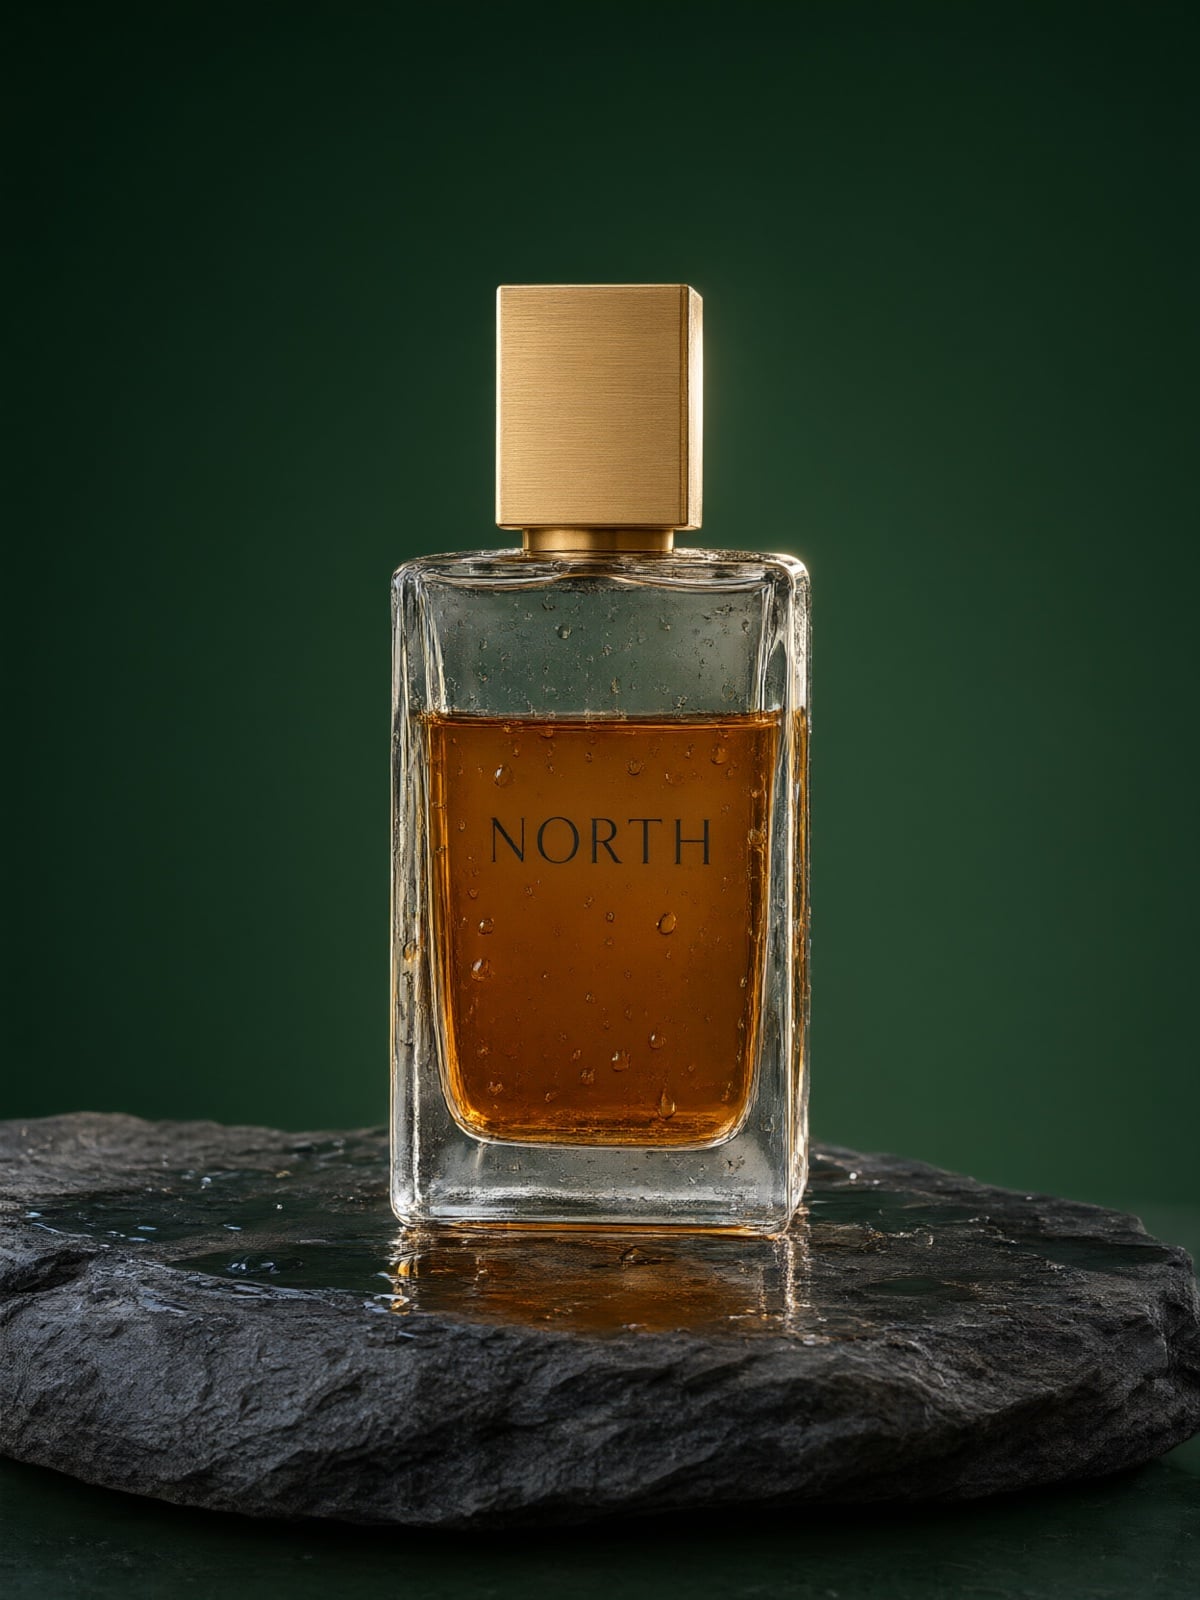
Photo produit d'une bouteille en verre
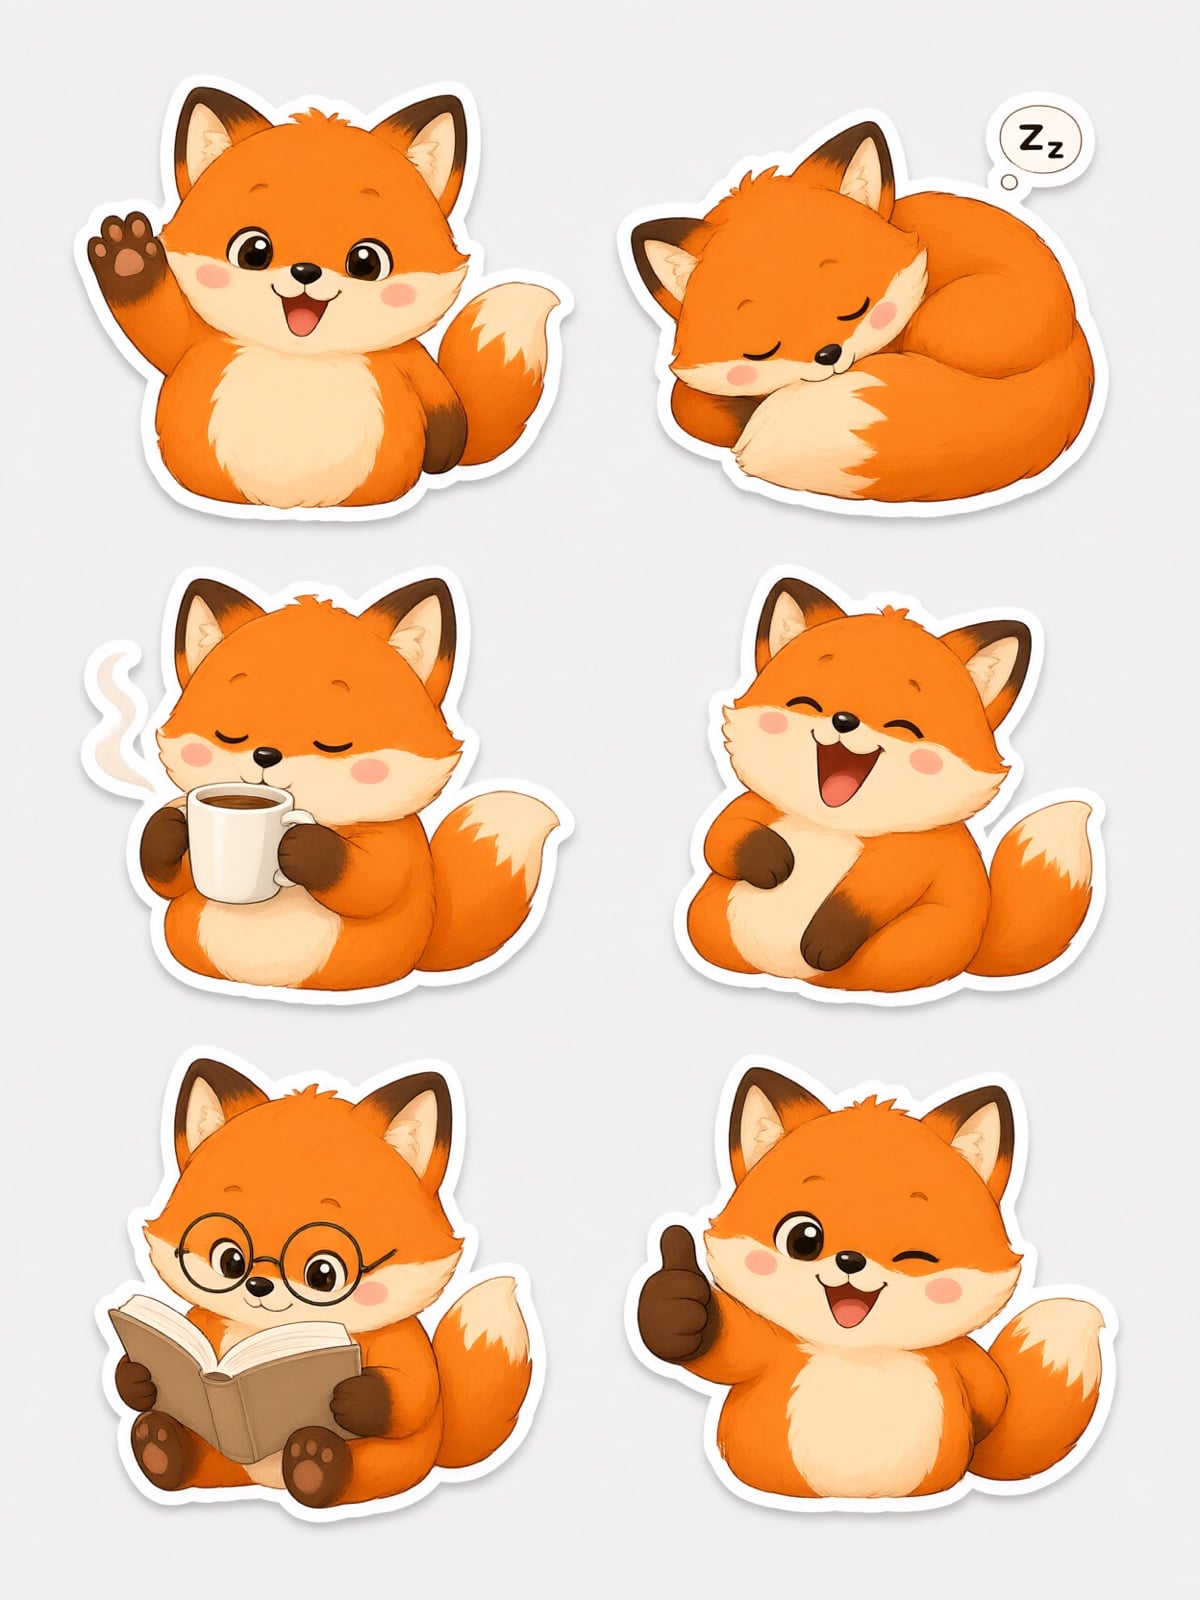
Planche d'autocollants de personnage
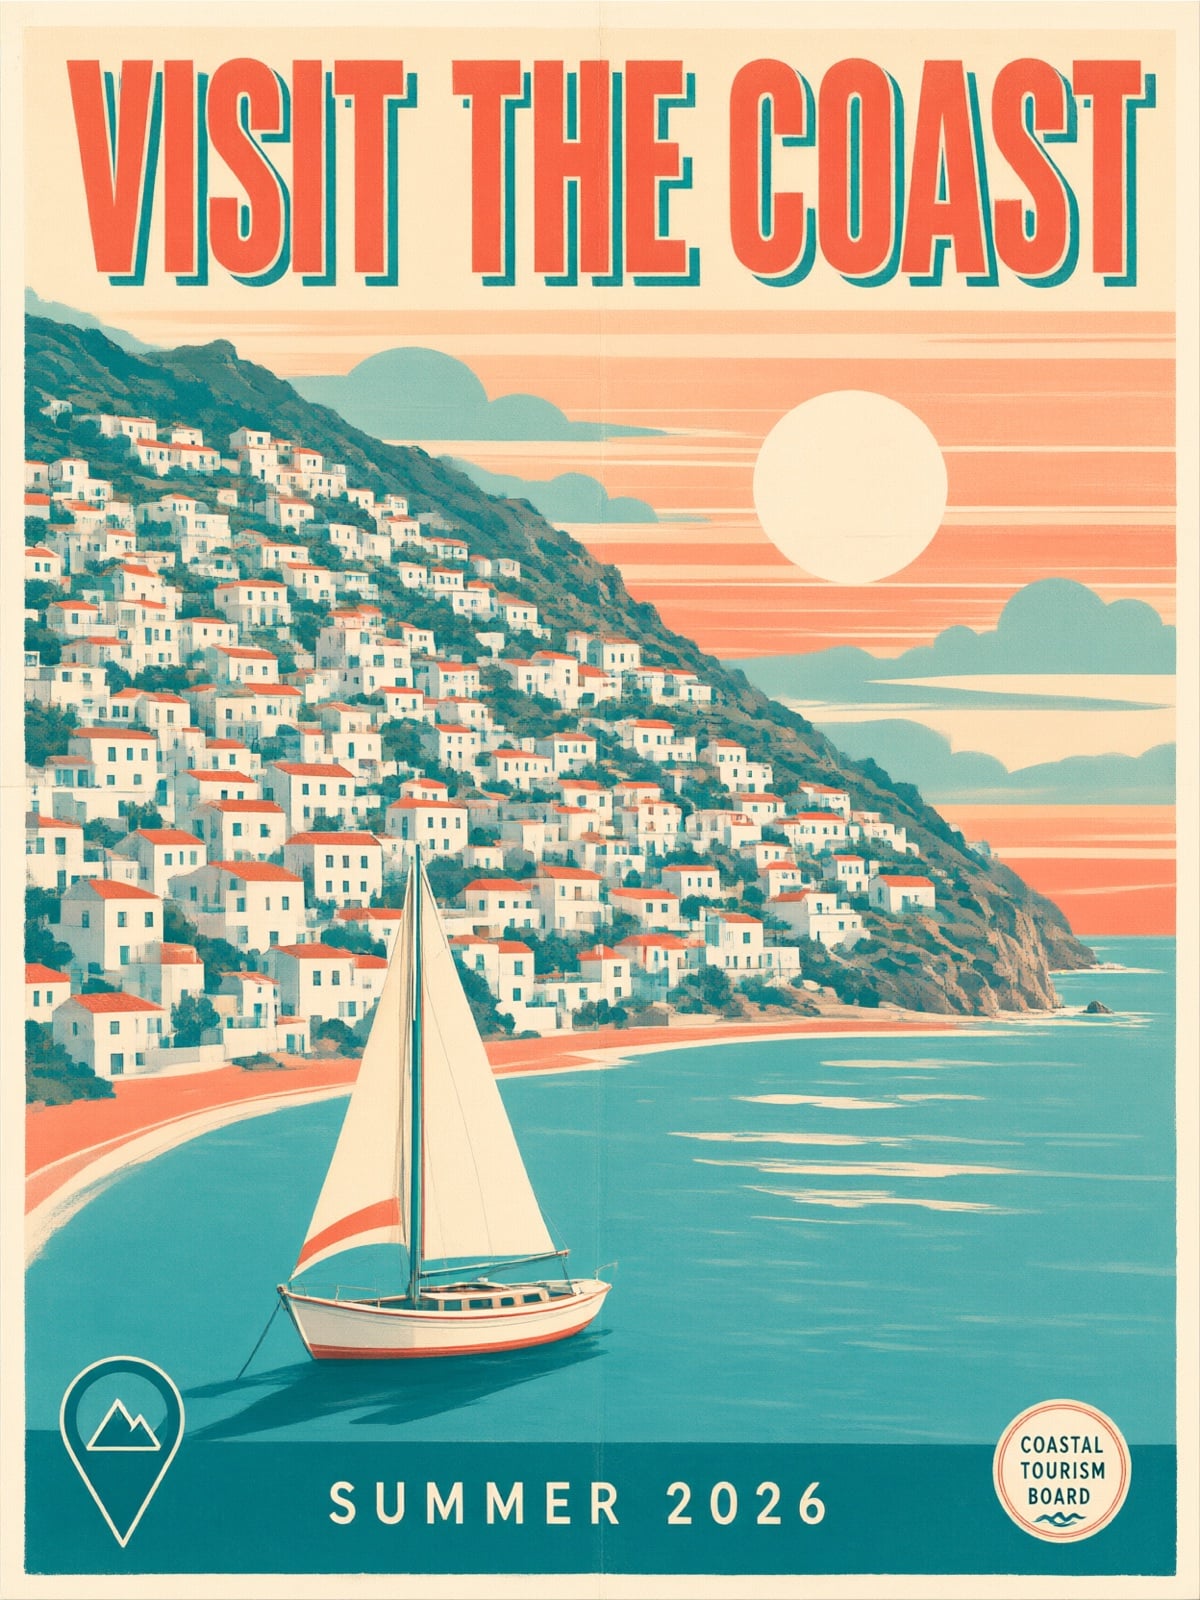
Affiche de voyage vintage
Qwen Image 3
Instruction
Exemples de prompts
Ouvre l'éditeur GoEnhance avec ce modèle et ce prompt déjà prêts.

Ce que Turbo change, et ce qu'il garde

8 étapes au lieu de 40

Le Qwen-Image-2.1 de base échantillonne en 40 étapes par défaut. Turbo est un checkpoint accéléré livré avec un planning de 8 étapes enregistré : chaque image demande donc un cinquième des étapes de débruitage. Selon Qwen, moins d'étapes ne veut pas dire une qualité moindre, et Turbo produit toujours des images 2K solides.

La même architecture de 7B

Turbo n'est pas un modèle plus petit. Il utilise la même architecture de génération visuelle de 7B que Qwen-Image-2.1, se charge via le même QwenImage21Pipeline dans Diffusers et accepte les mêmes tailles 2K recommandées, de 2048×2048 en carré à 2752×1536 en panoramique.

Génération et édition dans un seul checkpoint

Le même checkpoint gère le texte-vers-image et l'édition guidée par prompt. La fiche du modèle publiée par Qwen montre des éditions d'une seule image, des compositions multi-références et une pièce assemblée à partir de quatre images de référence. La famille Qwen-Image-2.1 accepte jusqu'à 10 images de référence.

CFG 1 et un planning fixe

Turbo est réglé pour tourner en CFG 1. Son planning de 8 étapes se charge automatiquement, et modifier seulement num_inference_steps ne le remplace pas : il faut passer des sigmas explicites, et Qwen précise que les autres plannings n'ont pas été évalués.

Poids ouverts et API hébergée

Les poids sont sur Hugging Face et ModelScope sous le Qwen Research License Agreement. Le même jour, les API Qwen-Image-2.1 Pro et Turbo ont été mises en ligne sur Alibaba Cloud Model Studio.

Comment exécuter Qwen-Image-2.1-Turbo
01

Récupérer les poids

Téléchargez Qwen/Qwen-Image-2.1-Turbo depuis Hugging Face ou ModelScope. Si votre projet est commercial, lisez le Qwen Research License Agreement avant de commencer.

02

Installer le runtime

Turbo nécessite Diffusers installé depuis les sources, car son planning s'appuie sur la prise en charge des sigmas d'échantillonnage ajoutée dans la PR #14950. Il vous faut aussi transformers 5.17 ou plus récent et une version CUDA de PyTorch.

03

Garder le planning par défaut

Chargez QwenImage21Pipeline et laissez tels quels le planning de 8 étapes enregistré et CFG 1. Pour éditer avec des images de référence, réglez use_kv_cache=True afin de mettre en cache le contexte texte et image.

04

Ou se passer d'installation

Pas de GPU sous la main ? Alibaba Cloud Model Studio sert l'API Turbo, ou essayez la famille Qwen Image dans votre navigateur avec la console de cette page.

comparatif

CritèreQwen-Image-2.1Qwen-Image-2.1-TurboQwen-Image-2.1 Pro
Date de sortie20 septembre 20269 octobre 20269 octobre 2026
Mode d'accèsPoids ouvertsPoids ouverts et API hébergéeAPI hébergée uniquement
Étapes de débruitage40 par défaut8, selon un planning enregistréNon publié
ArchitectureGénération visuelle de 7B, 32 couches DiTMême architecture de 7BNon publiée
TâchesTexte-vers-image, édition, RGBA transparent, retouches localesTexte-vers-image et éditionGénération et édition

Questions fréquentes sur Qwen-Image-2.1-Turbo
Qu'est-ce que Qwen-Image-2.1-Turbo ?
C'est le checkpoint accéléré officiel de Qwen-Image-2.1, publié par l'équipe Qwen le 9 octobre 2026. Il génère et édite des images en 8 étapes de débruitage et utilise la même architecture de génération visuelle de 7B que le modèle de base.

Combien est-il plus rapide que Qwen-Image-2.1 ?

Turbo utilise 8 étapes de débruitage là où le modèle de base en utilise 40 par défaut : il exécute donc un cinquième des étapes. Qwen n'a pas publié de temps mesuré, et la vitesse réelle dépend de votre GPU, de la taille de sortie et du nombre d'images de référence fournies.

Moins d'étapes veut-il dire des images moins bonnes ?

Selon Qwen, non, et Turbo produit toujours des images 2K solides. Si votre travail repose sur du texte dense ou de nombreuses images de référence, comparez Turbo au modèle de base sur vos propres prompts avant de changer.

Est-ce la même chose qu'un LoRA Qwen Image Turbo ?

Non. Qwen-Image-2.1-Turbo est un checkpoint complet publié par Qwen. Qwen-Image-2512 Turbo LoRA est un LoRA communautaire pour le modèle antérieur Qwen-Image-2512, et Qwen-Image-2.1-viggle-turbo est une publication communautaire distincte en 6 étapes, signée Viggle.

Puis-je utiliser Qwen-Image-2.1-Turbo dans ComfyUI ?

ComfyUI prend en charge le Qwen-Image-2.1 de base depuis sa sortie, avec des modèles de workflow officiels. Pour Turbo, utilisez un workflow qui charge le checkpoint Turbo et conserve son planning de 8 étapes et CFG 1. Le lancer avec les réglages en 40 étapes du modèle de base annule le gain de vitesse.

Puis-je l'utiliser sur GoEnhance ?

Pas encore. GoEnhance propose aujourd'hui Qwen Image 2, Qwen Image 2 Pro, Qwen Image 3 et Qwen Image 3 Pro. La console de cette page ouvre Qwen Image 3, pour essayer la famille Qwen sans installer de GPU.

Qwen-Image-2.1-Turbo est-il libre pour un usage commercial ?

Les poids sont publiés sous le Qwen Research License Agreement, qui n'équivaut pas à une licence commerciale classique. Lisez le texte de la licence avant d'utiliser les poids ou les résultats dans un projet commercial. L'API hébergée sur Alibaba Cloud a ses propres conditions.

Quelles résolutions prend-il en charge ?

Il travaille nativement en 2K. Les tailles recommandées sont 2048×2048, 2400×1792, 1792×2400, 2528×1696, 1696×2528, 2752×1536 et 1536×2752. Via l'API hébergée de Runware, chaque côté peut aller de 192 à 4096 pixels, pour 0,26 à 4,19 mégapixels et des formats de 1:8 à 8:1.

Combien d'images de référence accepte-t-il ?

La famille Qwen-Image-2.1 accepte jusqu'à 10 images de référence, et Turbo utilise le même pipeline d'édition. L'API Turbo hébergée de Runware accepte de 1 à 10 images de référence par requête.

Essayez la famille Qwen Image sur GoEnhance

Qwen-Image-2.1-Turbo tourne sur votre propre GPU ou via Alibaba Cloud. Pour essayer la génération d'images Qwen dans le navigateur sans rien installer, commencez par Qwen Image 3.

Commencer avec Qwen Image 3