Qwen-Image-2.1

Qwen-Image-2.1 est le modèle d'image à poids ouverts de l'équipe Qwen, publié le 20 septembre 2026. Il génère et édite dans un seul modèle, produit nativement des images RGBA transparentes, accepte jusqu'à 10 images de référence et travaille en 2K avec un transformeur de génération de 7B. GoEnhance n'héberge pas encore la 2.1 : la console ci-dessous ouvre Qwen Image 3, le modèle Qwen le plus récent disponible ici.
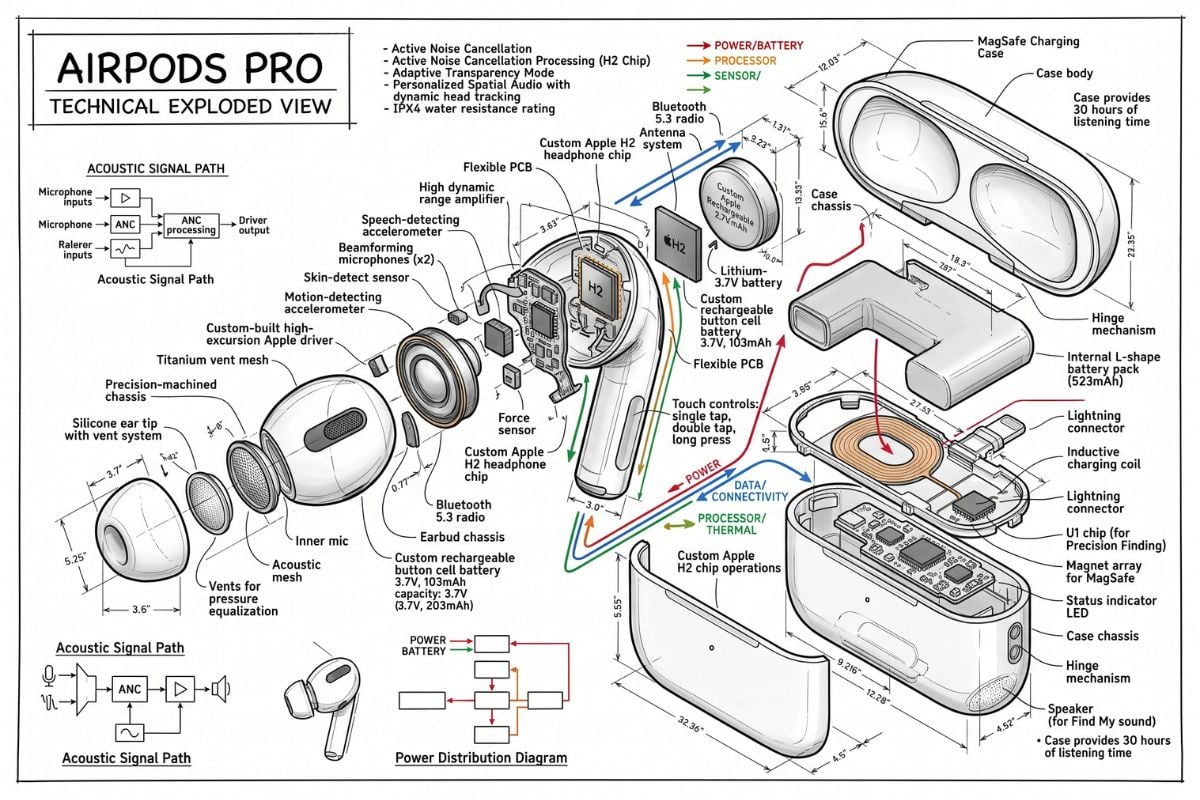
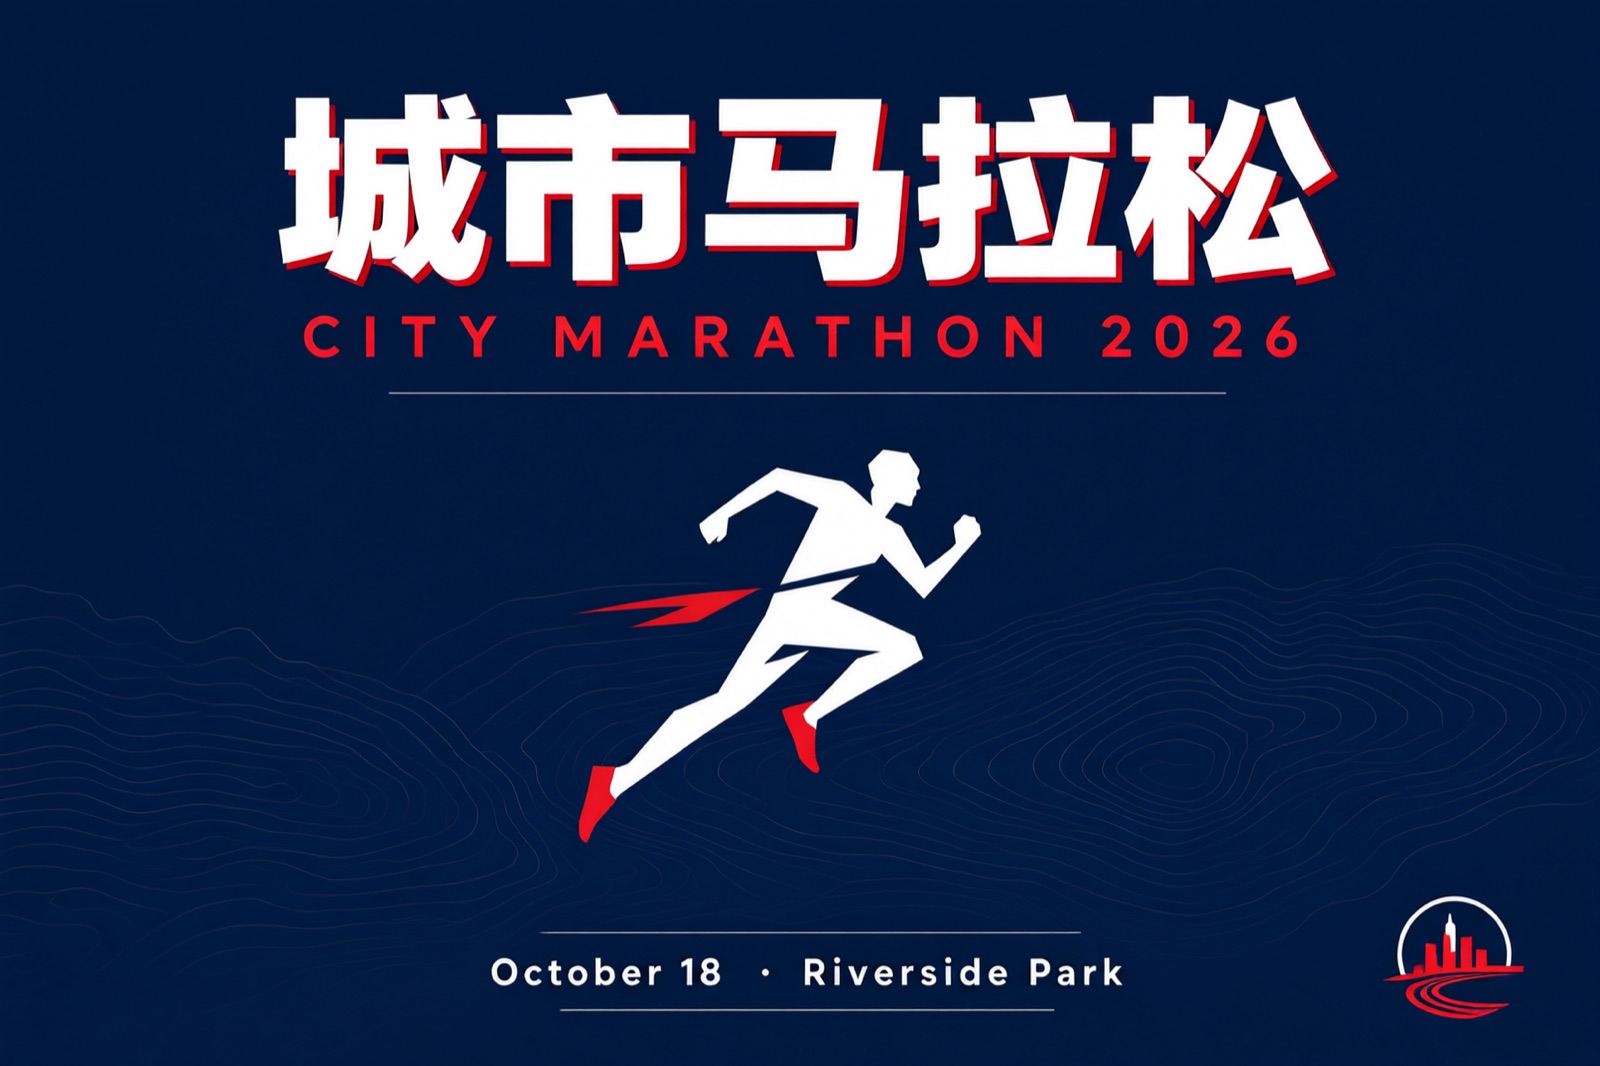
Typographie d'affiche bilingue
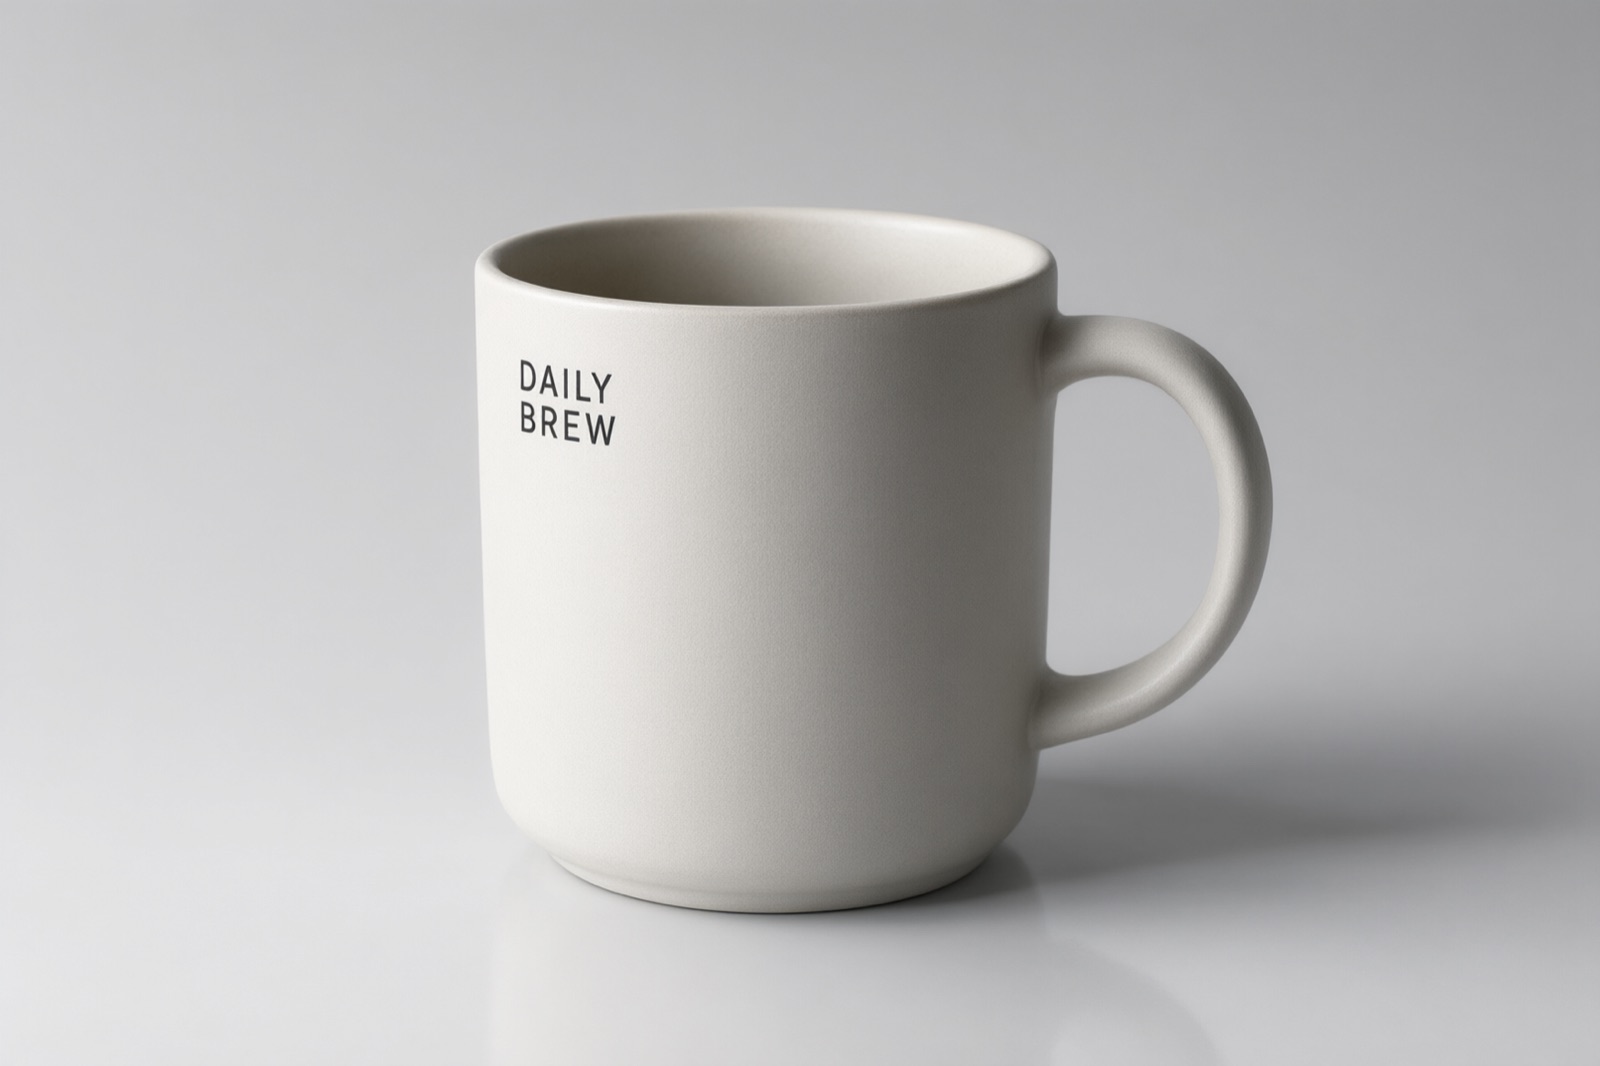
Photo produit avec étiquette lisible
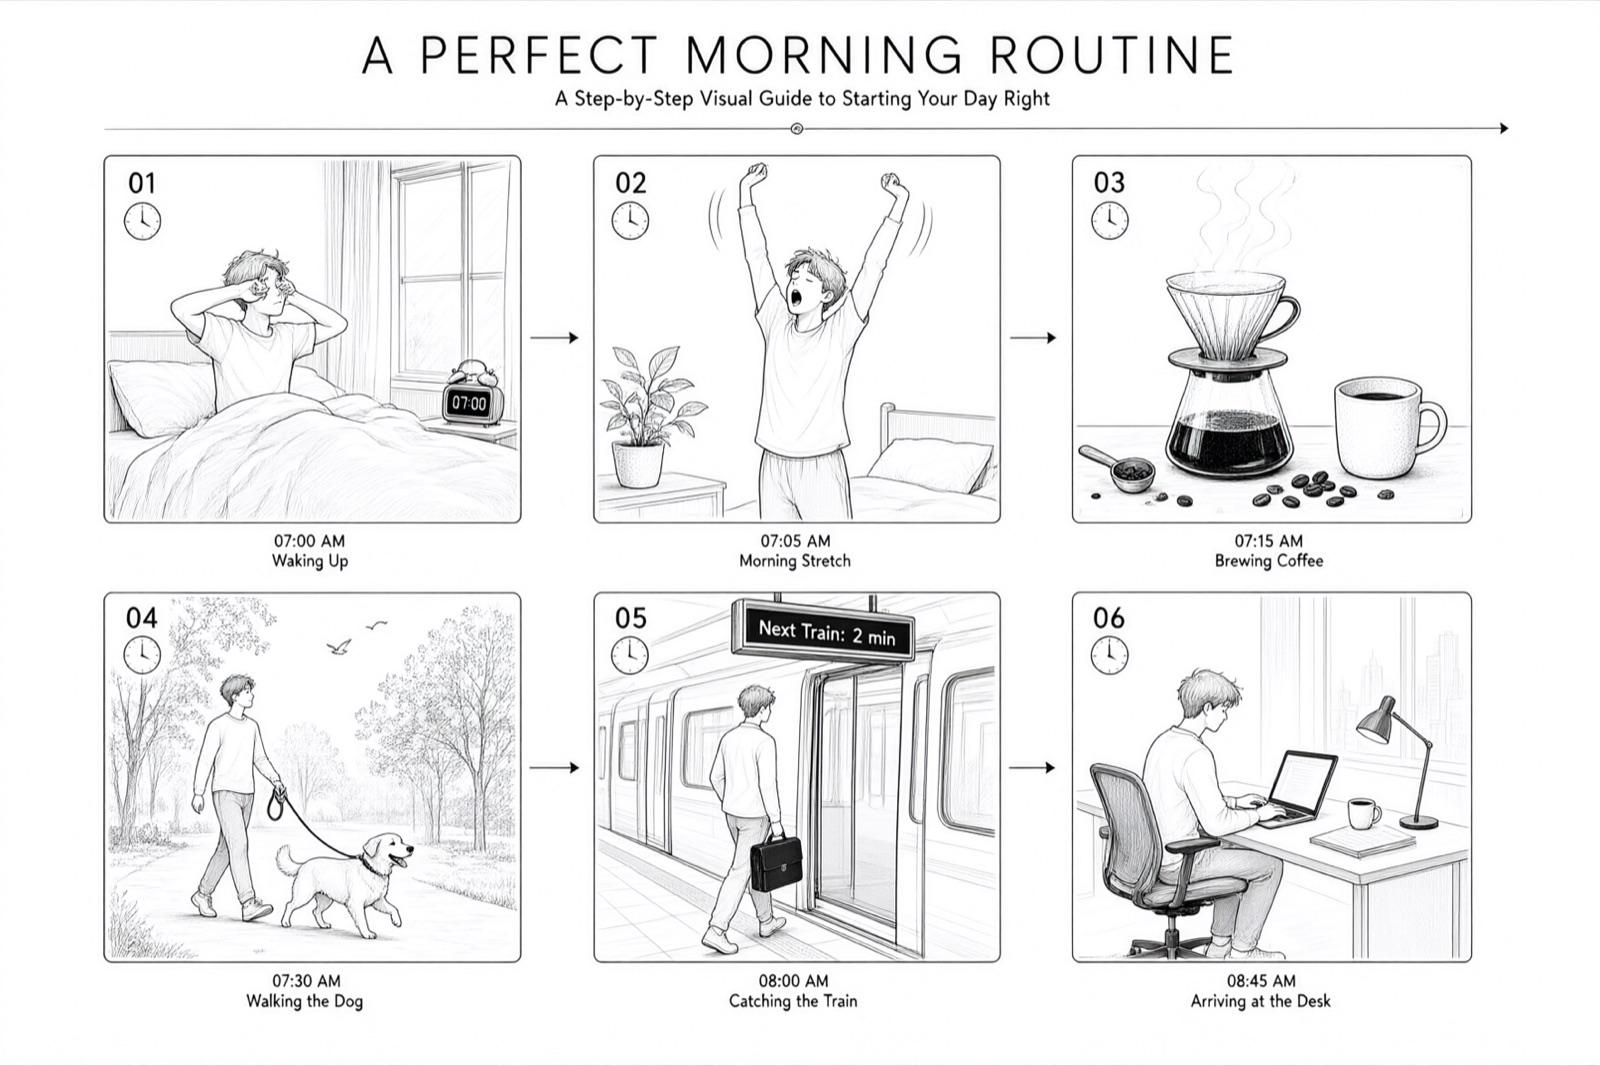
Storyboard en six cases
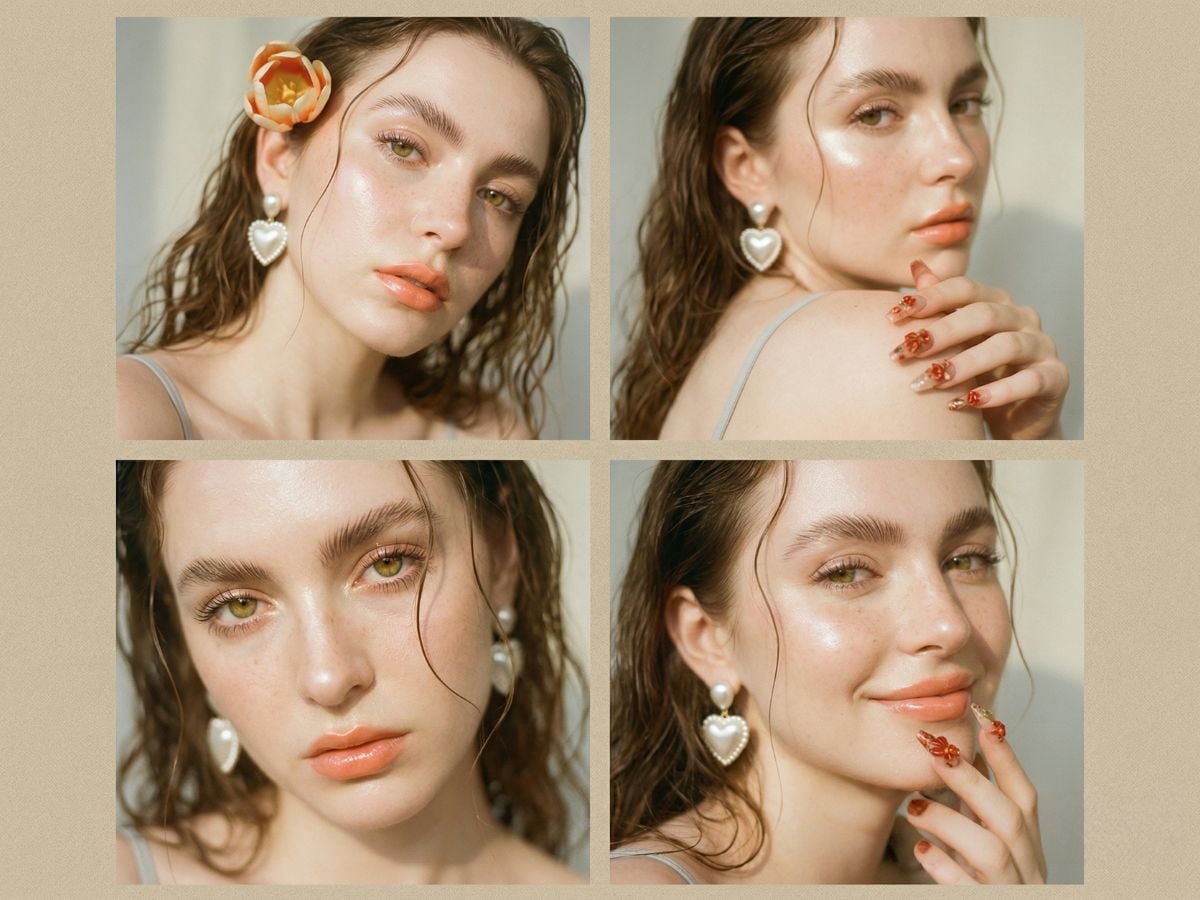
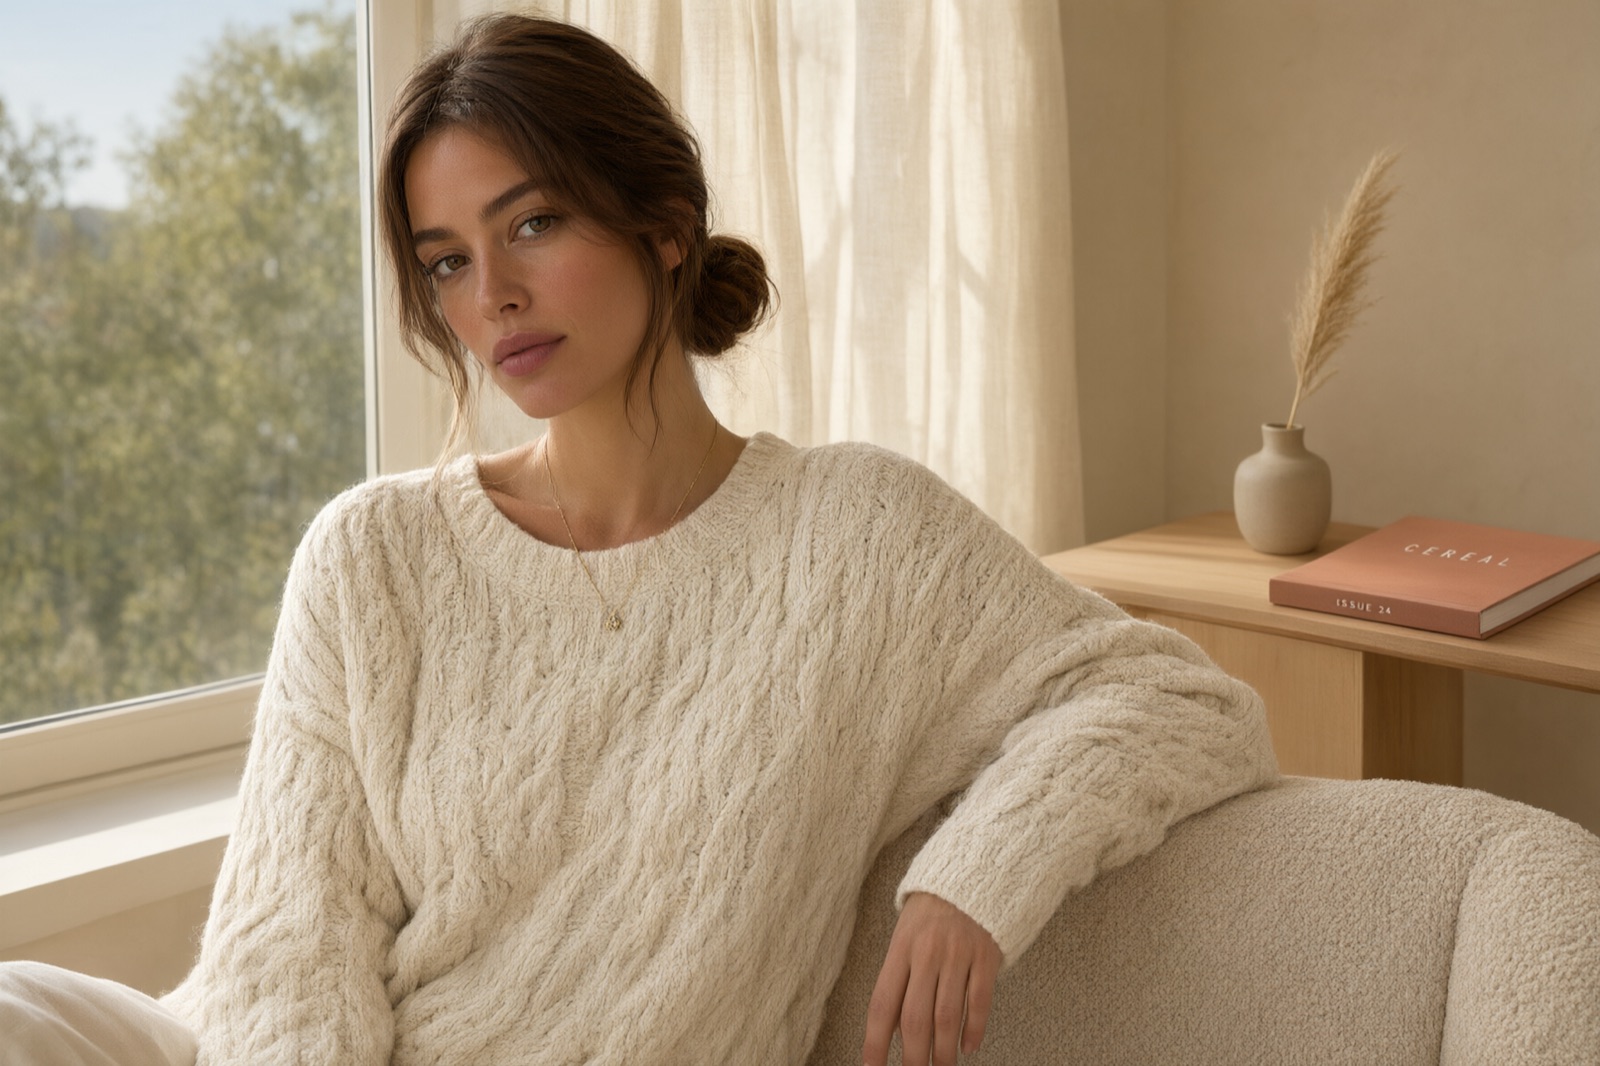
Portrait éditorial
Portrait éditorial
Qwen Image 3
Instruction
Exemples de prompts
Ouvre l'éditeur GoEnhance avec ce modèle et ce prompt déjà prêts.

Ce que vous pouvez créer avec Qwen Image sur GoEnhance

Des affiches dont le texte tient

Placez titres, dates et mentions légales en anglais ou en chinois et récupérez une mise en page où les lettres tiennent. Utile pour les affiches d'événement, les visuels clés et les couvertures sociales qui portent du vrai texte.

Des affiches dont le texte tient

Photos produit aux étiquettes lisibles

Posez un produit sur un fond net, gardez une lumière douce et une étiquette lisible. Parfait pour les visuels catalogue, les fiches boutique et les maquettes de packaging.

Photos produit aux étiquettes lisibles

Planches et grilles multi-cases

Demandez une planche de six cases, un explicatif en neuf cases ou une feuille de design : chaque case arrive dans le même style, avec les légendes où vous les voulez.

Planches et grilles multi-cases

Portraits à la peau et à la lumière naturelles

Générez des portraits éditoriaux avec une texture de peau crédible, des reflets dans les yeux et une lumière de fenêtre douce, puis retravaillez la tenue ou le cadrage sans perdre le visage.

Portraits à la peau et à la lumière naturelles

Les nouveautés de Qwen-Image-2.1

Une transparence native, pas un détourage

Qwen-Image-2.1 embarque un autoencodeur RGBA à 64 canaux avec compression spatiale 16x : la transparence fait partie du modèle et non du post-traitement. Images transparentes depuis le prompt, édition de calques transparents et extraction de sujets dans des photos ordinaires.

Un seul modèle pour générer et éditer

Le texte-vers-image et l'édition passent par le même pipeline. Vous partez d'un prompt, confiez une image à modifier, ou les deux dans une même requête, sans changer de checkpoint.

Jusqu'à 10 images de référence

Donnez jusqu'à dix références dans une même édition : une photo de groupe composée à partir de portraits individuels, ou une tenue complète assemblée depuis des prises séparées du mannequin, des vêtements, des chaussures, du sac et du chapeau.

Montrez ce qui doit changer

Les retouches locales se marquent par un cercle, une annotation peinte ou un masque séparé. Le modèle préserve l'identité des personnes et des produits et ne modifie que la zone marquée.

Une architecture compacte de 7B

Le transformeur de génération compte 32 couches DiT en flux unique pour 7B de paramètres, avec un encodeur de texte Qwen3-VL 8B. L'attention à granularité mixte et la réutilisation du cache KV de préfixe encodent le prompt et les références une fois, puis les réutilisent à chaque étape.

2K natif et typographie plus nette

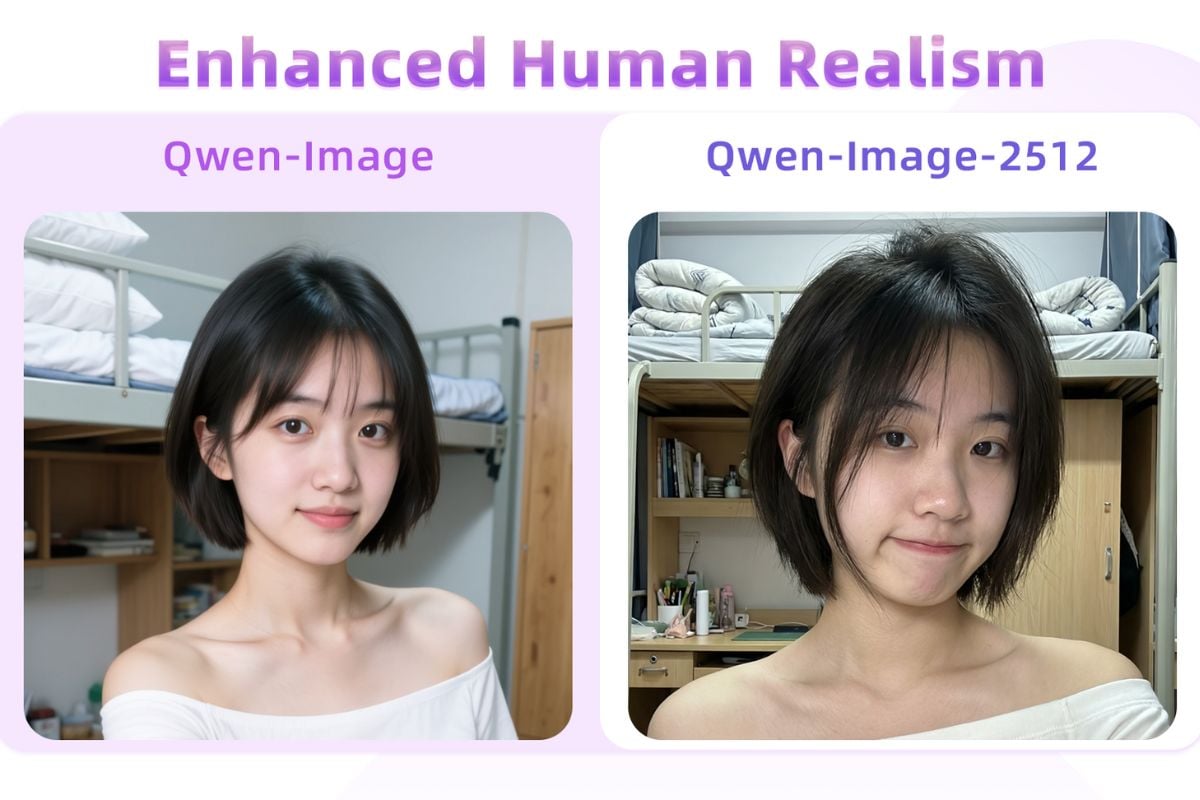
Les tailles recommandées vont de 2048x2048 en carré à 2752x1536 en 16:9, avec 40 étapes par défaut. Typographie, lumière de portrait et textures fines progressent par rapport à la version précédente de Qwen-Image.

Exécuter Qwen-Image-2.1 chez vous

01

Récupérer les poids

Qwen-Image-2.1 est à poids ouverts. Téléchargez-le depuis Hugging Face (Qwen/Qwen-Image-2.1) ou ModelScope, ou prenez la copie prête pour ComfyUI sur Comfy-Org/Qwen-Image-2.1.

02

Choisir un runtime

Diffusers le prend en charge dès le premier jour via QwenImage21Pipeline, et ComfyUI fournit des workflows natifs de génération et d'édition. Pour un usage plus lourd, vLLM-Omni, SGLang et LightX2V ajoutent le cache de préfixe, la quantification et l'inférence multi-GPU ; AMD ROCm et les puces FlagOS sont également pris en charge.

03

Prompt, taille et transparence

Partez des checkpoints officiels de réécriture de prompts (PE-T2I pour la génération, PE-I2I pour l'édition), tenez-vous aux tailles 2K recommandées et aux 40 étapes, et pour un rendu transparent ouvrez le prompt par la formulation RGBA attendue par le modèle.

Qwen-Image-2.1 comparé à Qwen Image sur GoEnhance

CritèreQwen-Image-2.1 (poids ouverts)Qwen Image 3 (ici sur GoEnhance)
Où ça tourneVotre propre GPU, ou un runtime cloud que vous installezDans le navigateur, rien à installer
Sortie RGBA transparenteNative, édition de calques transparents compriseNon disponible
Images de référenceJusqu'à 10 par éditionImage de référence prise en charge dans l'éditeur
Résolution2K natif, jusqu'à 2752x1536Sortie en 1K et 2K
Rendu du texteTypographie améliorée en anglais et en chinoisTexte bilingue solide et mises en page denses
Pour démarrerTélécharger les poids, installer un runtime, gérer son GPUÉcrire un prompt et générer

Questions fréquentes sur Qwen-Image-2.1

Qu'est-ce que Qwen-Image-2.1 ?

Qwen-Image-2.1 est un modèle d'image à poids ouverts de l'équipe Qwen qui réunit génération depuis le texte et édition dans un seul modèle. Son transformeur de génération compte 7B de paramètres sur 32 couches DiT en flux unique et produit nativement des images RGBA transparentes. Les poids ont été publiés le 20 septembre 2026.

Puis-je utiliser Qwen-Image-2.1 sur GoEnhance ?

Pas encore. GoEnhance propose aujourd'hui Qwen Image 2, Qwen Image 2 Pro, Qwen Image 3 et Qwen Image 3 Pro. La console de cette page ouvre Qwen Image 3, le modèle Qwen le plus récent disponible ici, pour essayer la famille sans installer de GPU.

Est-il libre pour un usage commercial ?

Le dépôt est publié sous le Qwen Research License Agreement, qui n'équivaut pas à une licence commerciale classique. Lisez le texte de la licence dans le dépôt GitHub avant d'utiliser les poids ou les résultats dans un projet commercial.

Comment génère-t-il des images transparentes ?

La transparence est intégrée à l'autoencodeur : un VAE RGBA à 64 canaux avec compression spatiale 16x. Vous la demandez dans le prompt, en précisant une image RGBA à fond transparent, et vous obtenez un vrai canal alpha plutôt qu'un détourage.

Quel matériel faut-il ?

C'est un modèle de génération de 7B avec un encodeur de texte de 8B : en pratique, il faut un GPU récent avec assez de VRAM. Les runtimes communautaires aident : vLLM-Omni et SGLang proposent des poids FP8, le déchargement CPU et le parallélisme multi-GPU, et LightX2V vise les cartes grand public.

Combien d'images de référence accepte-t-il ?

Jusqu'à dix dans une même édition. C'est ce qui rend la composition multi-sujets praticable : plusieurs personnes dans une scène, ou une tenue assemblée depuis des photos produit séparées, chaque élément restant reconnaissable.

Essayez la famille Qwen Image sur GoEnhance

Qwen-Image-2.1 est à poids ouverts et tourne sur votre matériel. Si vous préférez écrire un prompt et recevoir une image, ouvrez Qwen Image 3 sur GoEnhance et partez de l'un des exemples ci-dessus.

Commencer avec Qwen Image 3