Qwen-Image-2.1

Qwen-Image-2.1 è il modello di immagini a pesi aperti del team Qwen, pubblicato il 20 settembre 2026. Genera e modifica in un unico modello, produce immagini RGBA trasparenti in modo nativo, accetta fino a 10 immagini di riferimento e lavora in 2K con un transformer di generazione da 7B. GoEnhance non ospita ancora la 2.1: la console qui sotto apre Qwen Image 3, il modello Qwen più recente disponibile qui.
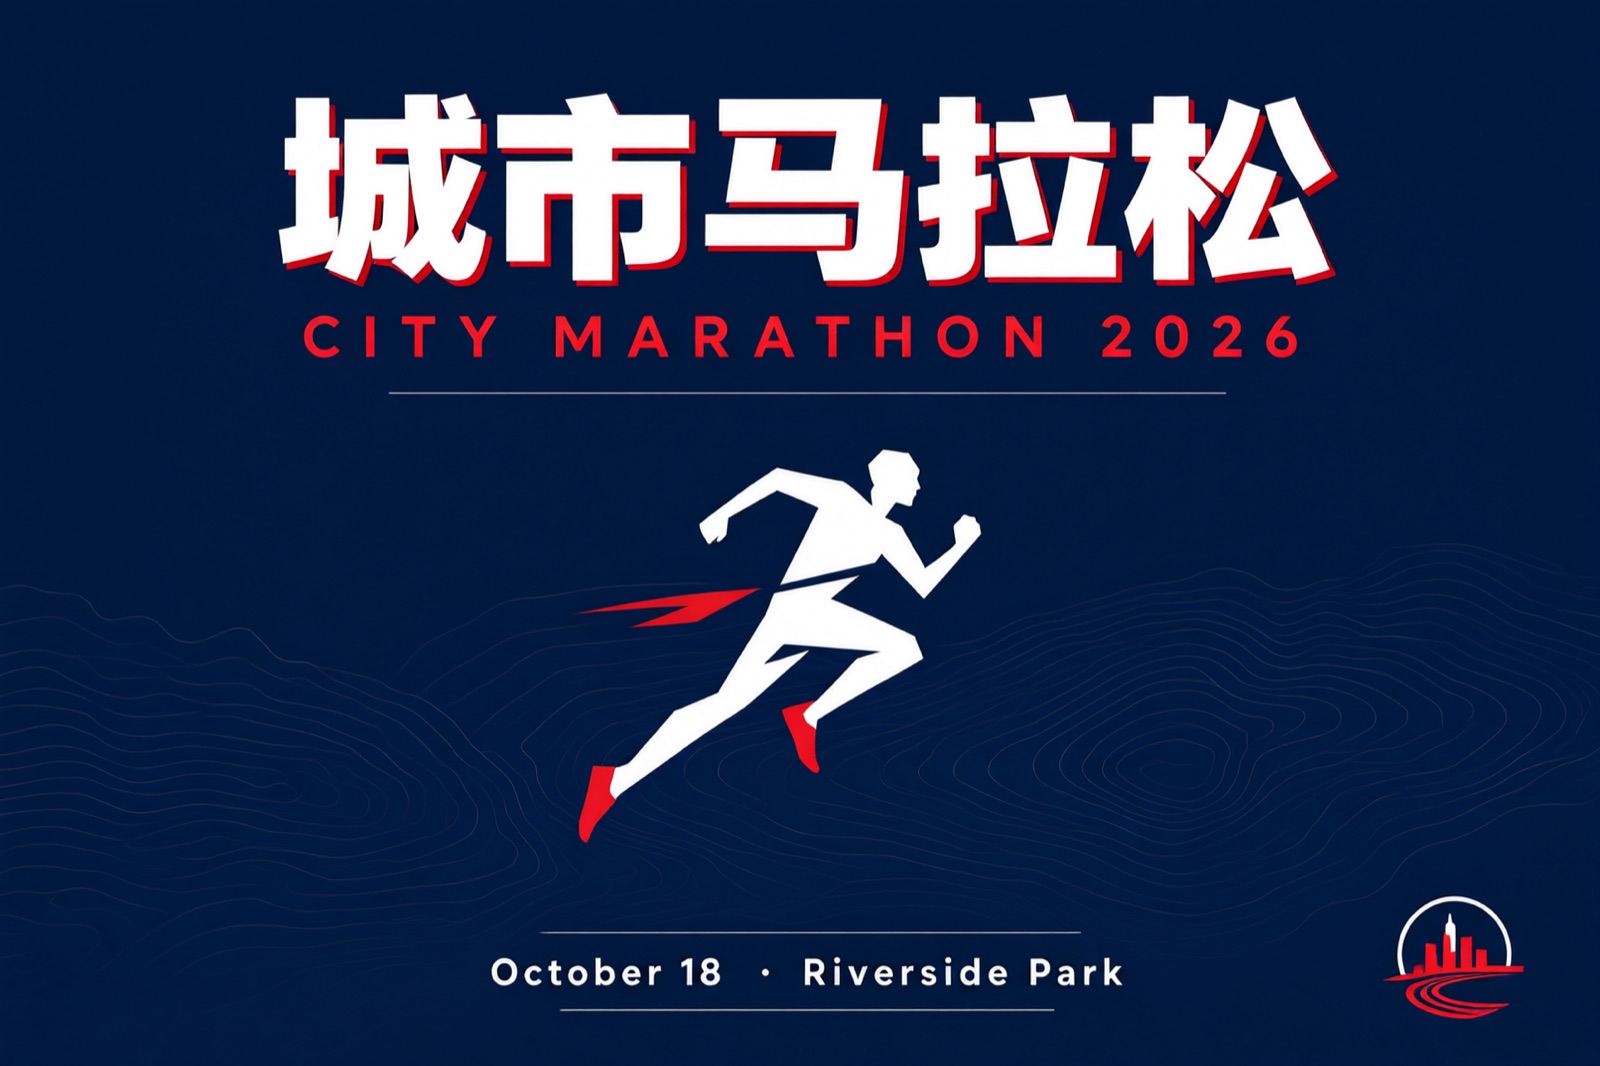
Tipografia di poster bilingue
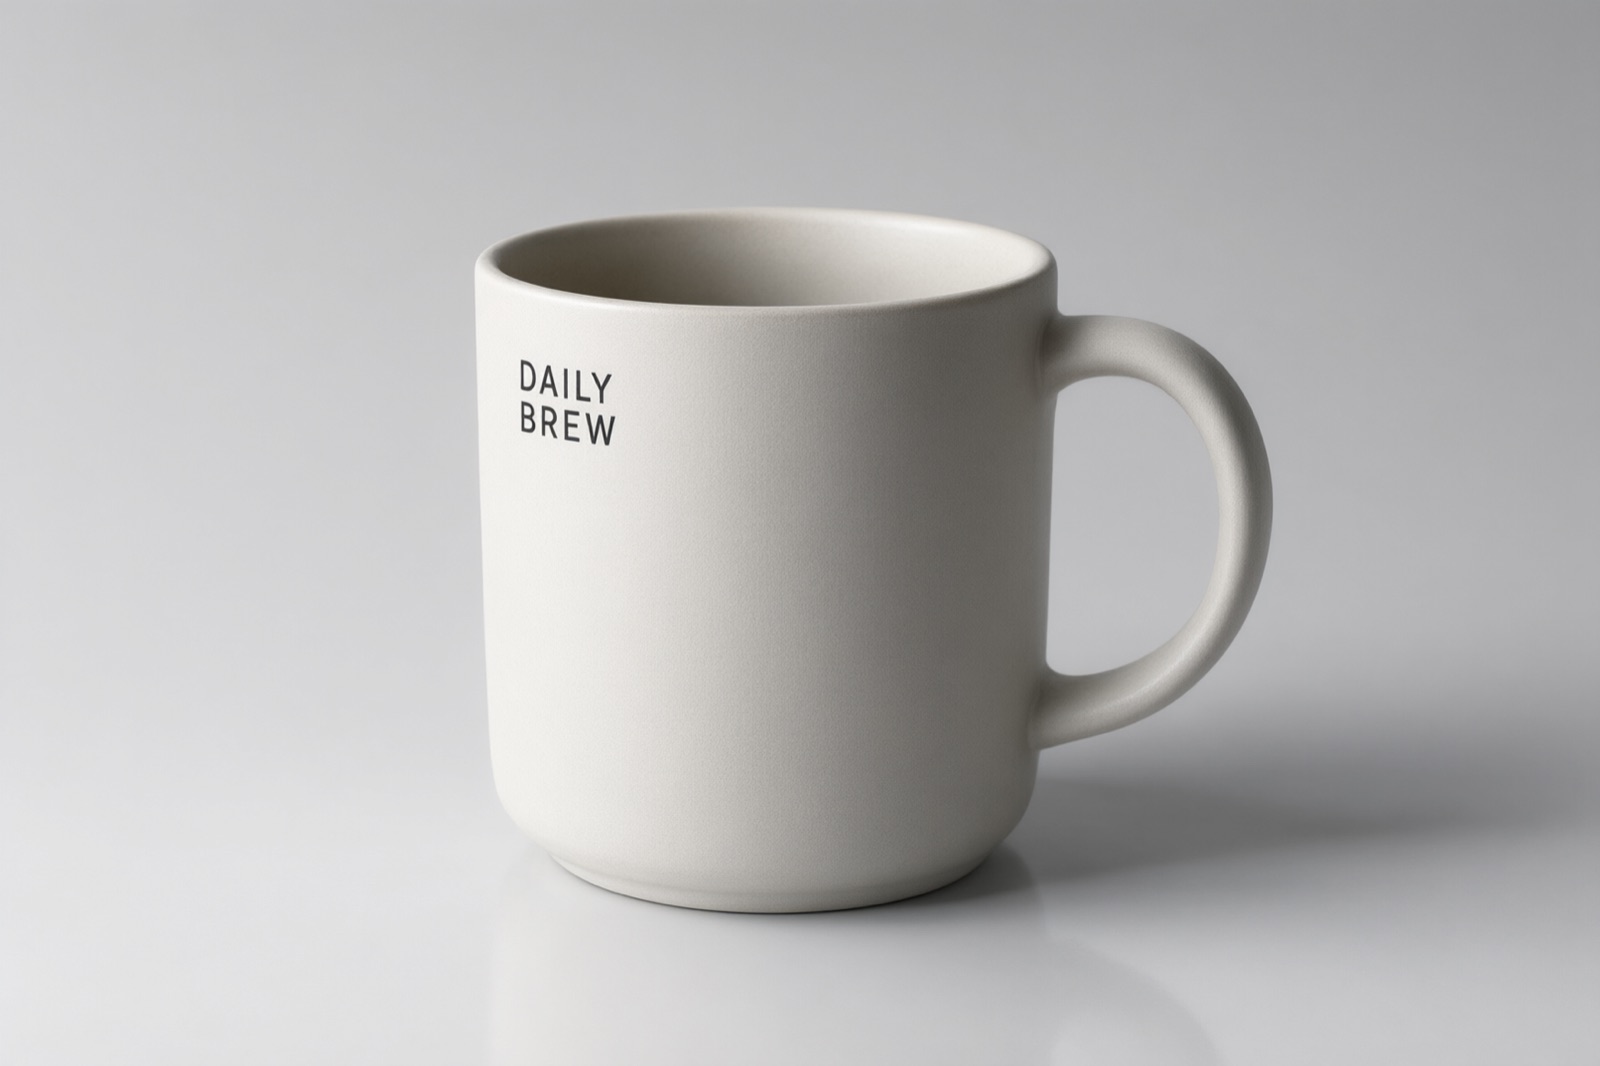
Foto di prodotto con etichetta leggibile
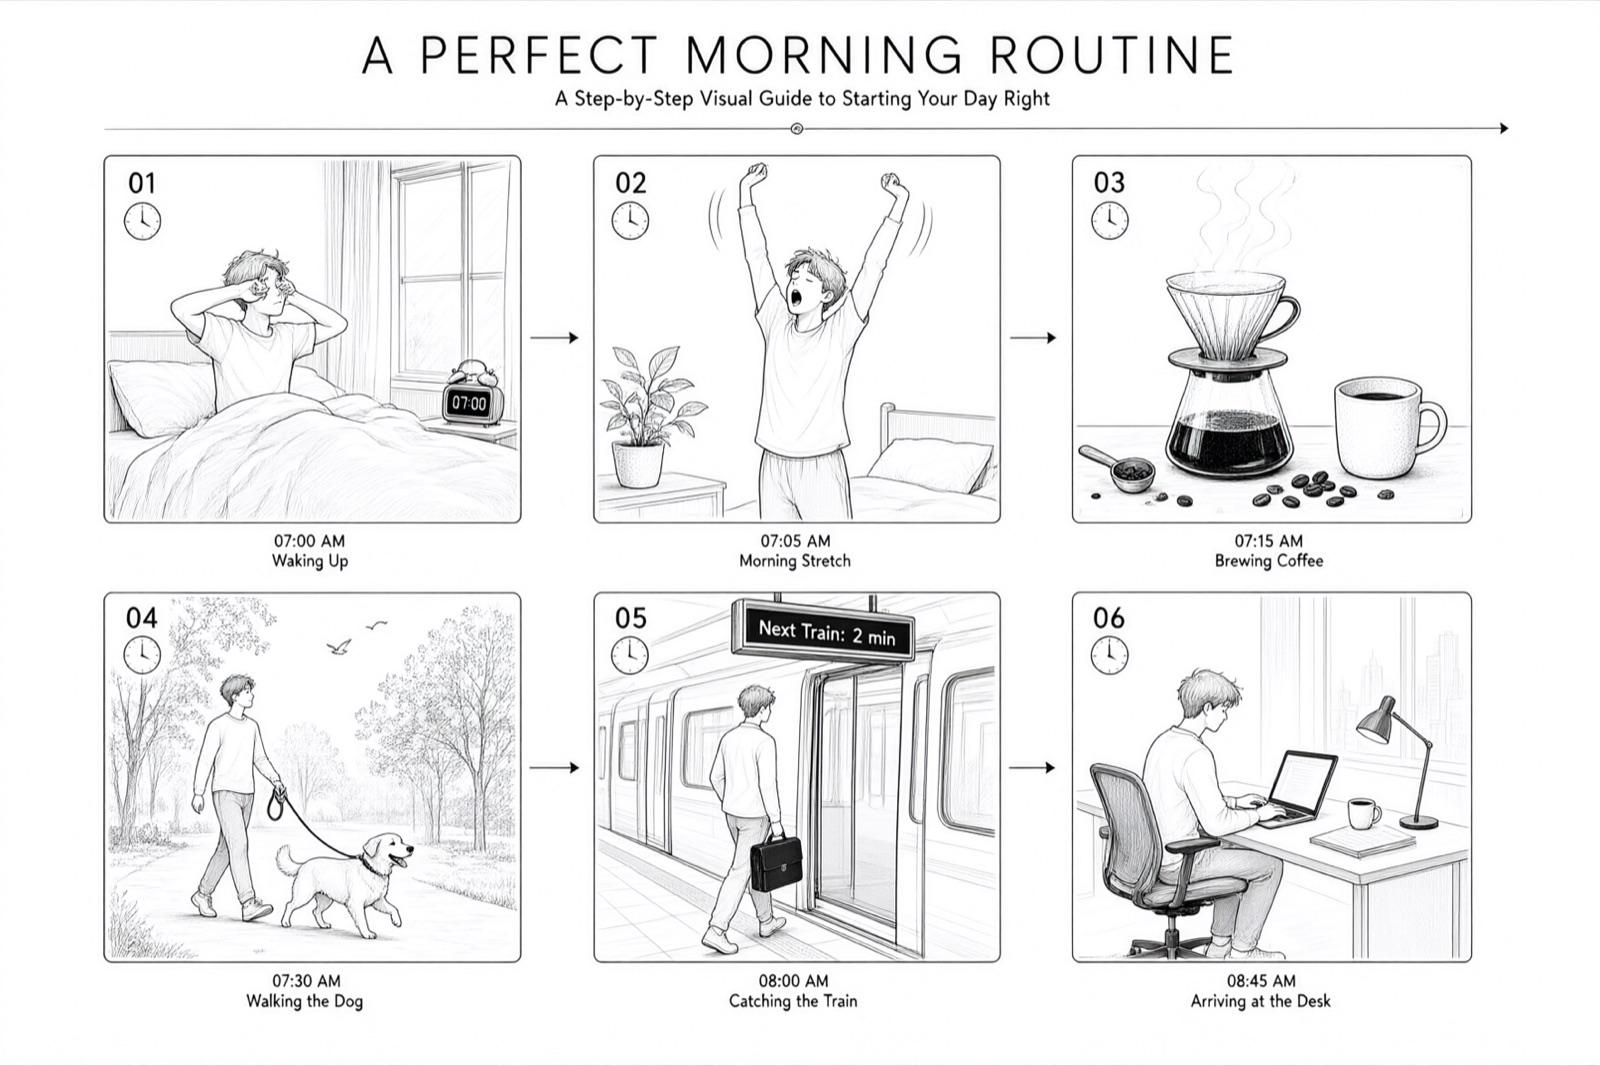
Storyboard a sei riquadri
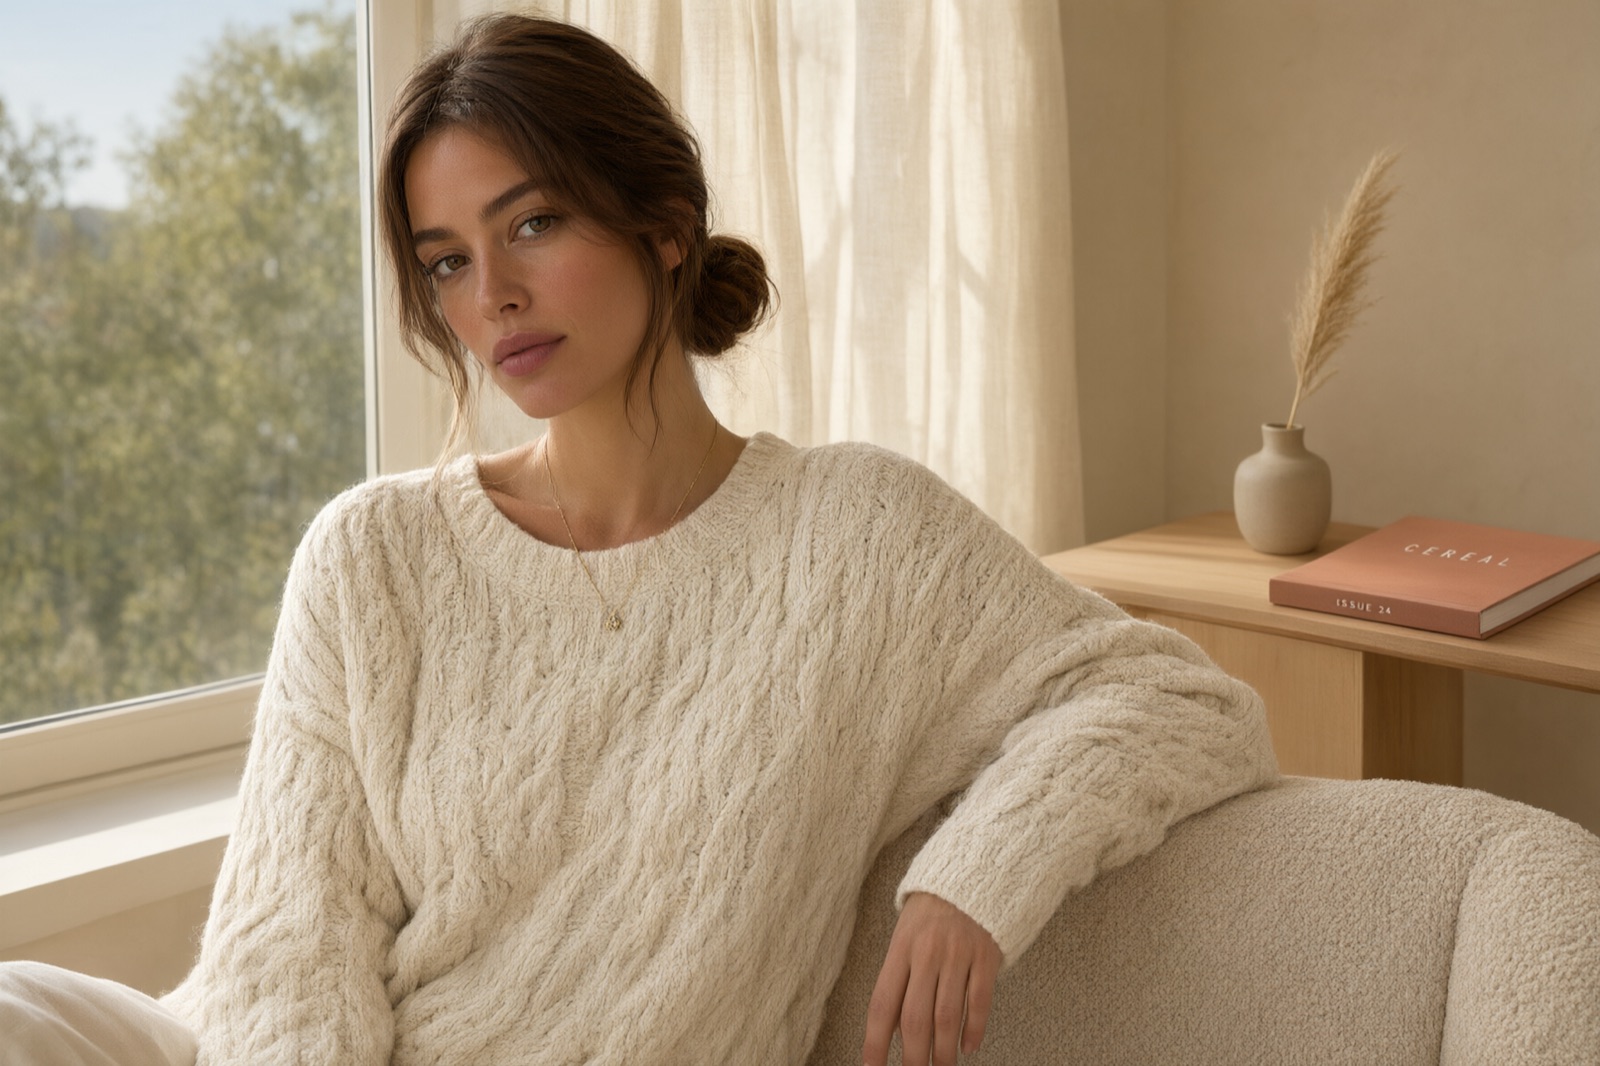
Ritratto editoriale
Ritratto editoriale
Qwen Image 3
Prompt
Prompt di esempio
Apre l'editor GoEnhance con questo modello e prompt già pronti.

Cosa puoi creare con Qwen Image su GoEnhance

Poster con testo che regge

Imposta titoli, date e testo piccolo in inglese o cinese e ottieni un layout in cui le lettere restano leggibili. Utile per locandine, key visual e copertine social con testo vero.

Poster con testo che regge

Foto di prodotto con etichette leggibili

Metti il prodotto su uno sfondo pulito, mantieni la luce morbida e l'etichetta nitida. Adatto a immagini di catalogo, schede prodotto e bozze di packaging.

Foto di prodotto con etichette leggibili

Tavole e griglie a più riquadri

Chiedi una tavola da sei riquadri, un explainer a nove caselle o un design sheet: ogni riquadro arriva con lo stesso stile e le didascalie dove servono.

Tavole e griglie a più riquadri

Ritratti con pelle e luce naturali

Genera ritratti editoriali con texture della pelle credibile, riflessi negli occhi e luce morbida di finestra, poi cambia abito o inquadratura senza perdere il volto.

Ritratti con pelle e luce naturali

Cosa c'è di nuovo in Qwen-Image-2.1

Trasparenza nativa, non uno scontorno

Qwen-Image-2.1 integra un autoencoder RGBA a 64 canali con compressione spaziale 16x: la trasparenza sta nel modello e non nella post-produzione. Immagini trasparenti dal prompt, modifica di livelli trasparenti ed estrazione di soggetti da foto normali.

Un solo modello per generare e modificare

Testo-immagine e modifica passano dalla stessa pipeline. Puoi partire da un prompt, consegnare un'immagine da cambiare o fare entrambe le cose in una richiesta, senza cambiare checkpoint.

Fino a 10 immagini di riferimento

Passa fino a dieci riferimenti in una singola modifica: una foto di gruppo costruita da ritratti separati, o un outfit completo assemblato da scatti distinti di modella, abiti, scarpe, borsa e cappello.

Indica cosa deve cambiare

Le modifiche locali si segnano con un cerchio, un'annotazione dipinta o una maschera separata. Il modello conserva l'identità di persone e prodotti e cambia solo l'area indicata.

Architettura compatta da 7B

Il transformer di generazione è composto da 32 layer DiT single-stream per 7B di parametri, affiancati da un text encoder Qwen3-VL 8B. Attenzione a granularità mista e riuso della cache KV di prefisso codificano prompt e riferimenti una volta sola, riusandoli a ogni passo.

2K nativo e testo più nitido

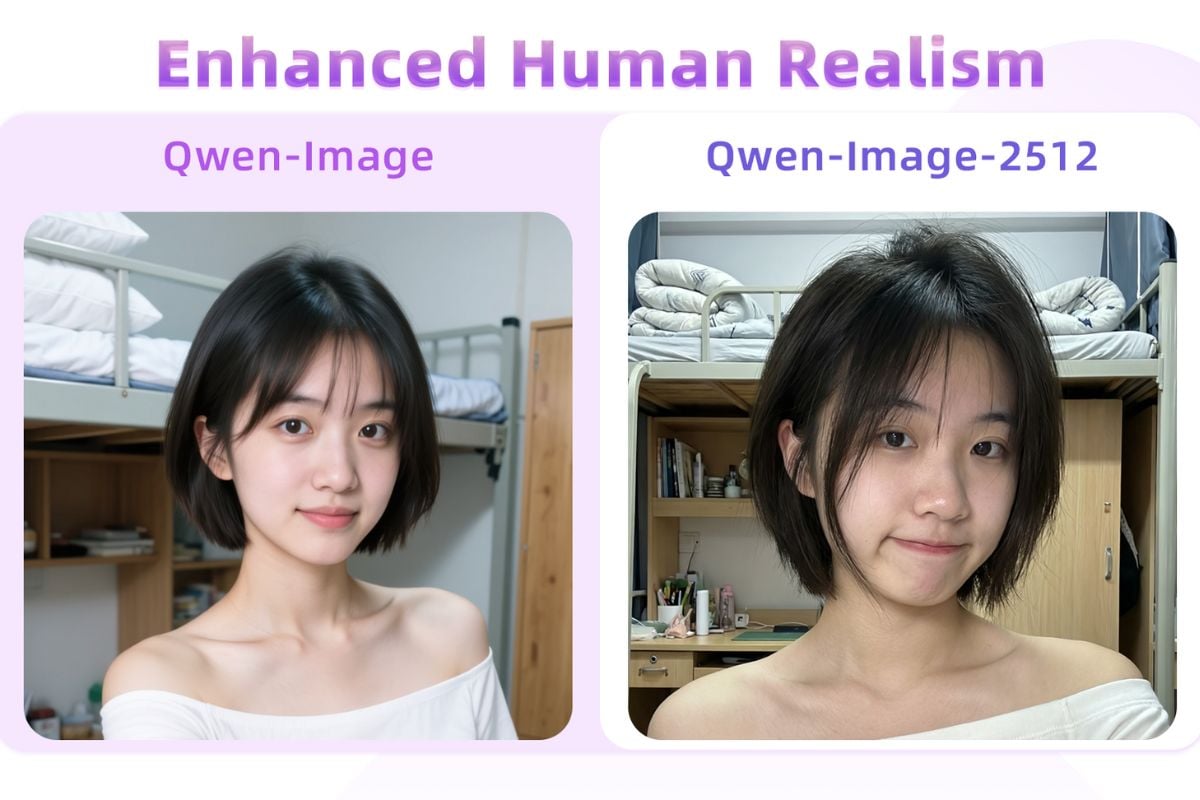
Le dimensioni consigliate vanno da 2048x2048 in quadrato a 2752x1536 in 16:9, con 40 passi di default. Tipografia, luce sui ritratti e texture fini migliorano rispetto alla versione precedente di Qwen-Image.

Come eseguire Qwen-Image-2.1 in proprio

01

Scarica i pesi

Qwen-Image-2.1 è a pesi aperti. Scaricalo da Hugging Face (Qwen/Qwen-Image-2.1) o ModelScope, oppure prendi la copia pronta per ComfyUI da Comfy-Org/Qwen-Image-2.1.

02

Scegli un runtime

Diffusers lo supporta dal primo giorno con QwenImage21Pipeline e ComfyUI include workflow nativi per generazione e modifica. Per carichi più pesanti, vLLM-Omni, SGLang e LightX2V aggiungono cache di prefisso, quantizzazione e inferenza multi-GPU; sono supportati anche AMD ROCm e i chip FlagOS.

03

Prompt, dimensioni e trasparenza

Parti dai checkpoint ufficiali di riscrittura del prompt (PE-T2I per generare, PE-I2I per modificare), resta sulle dimensioni 2K consigliate e sui 40 passi e, per un risultato trasparente, apri il prompt con la formula RGBA che il modello si aspetta.

Qwen-Image-2.1 a confronto con Qwen Image su GoEnhance

AspettoQwen-Image-2.1 (pesi aperti)Qwen Image 3 (qui su GoEnhance)
Dove giraLa tua GPU o un runtime cloud che configuri tuNel browser, senza installare nulla
Output RGBA trasparenteNativo, inclusa la modifica di livelli trasparentiNon disponibile
Immagini di riferimentoFino a 10 in una modificaImmagine di riferimento supportata nell'editor
Risoluzione2K nativo, fino a 2752x1536Output in 1K e 2K
Resa del testoTipografia migliorata in inglese e cineseTesto bilingue solido e layout densi
Per iniziareScaricare i pesi, installare un runtime, gestire la GPUScrivere un prompt e generare

Domande frequenti su Qwen-Image-2.1

Che cos'è Qwen-Image-2.1?

Qwen-Image-2.1 è un modello di immagini a pesi aperti del team Qwen che unisce generazione da testo e modifica in un unico modello. Il transformer di generazione ha 7B di parametri su 32 layer DiT single-stream e produce immagini RGBA trasparenti in modo nativo. I pesi sono stati pubblicati il 20 settembre 2026.

Posso usare Qwen-Image-2.1 su GoEnhance?

Non ancora. Su GoEnhance girano Qwen Image 2, Qwen Image 2 Pro, Qwen Image 3 e Qwen Image 3 Pro. La console di questa pagina apre Qwen Image 3, il modello Qwen più recente disponibile qui, così puoi provare la famiglia senza configurare una GPU.

È gratuito per lavori commerciali?

Il repository è pubblicato sotto il Qwen Research License Agreement, che non equivale a una normale licenza commerciale. Leggi il testo della licenza nel repository GitHub prima di usare pesi o risultati in un progetto commerciale.

Come genera immagini trasparenti?

La trasparenza è nell'autoencoder: un VAE RGBA a 64 canali con compressione spaziale 16x. La chiedi nel prompt, dichiarando un'immagine RGBA con sfondo trasparente, e ottieni un canale alfa reale invece di uno scontorno.

Che hardware serve?

È un modello di generazione da 7B con un text encoder da 8B, quindi in pratica serve una GPU recente con VRAM sufficiente. I runtime della community aiutano: vLLM-Omni e SGLang offrono pesi FP8, offload su CPU e parallelismo multi-GPU, mentre LightX2V punta alle schede consumer.

Quante immagini di riferimento accetta?

Fino a dieci in una modifica. È questo che rende pratica la composizione con più soggetti: più persone in una scena, o un outfit assemblato da foto di prodotto separate, mantenendo ogni elemento riconoscibile.

Prova la famiglia Qwen Image su GoEnhance

Qwen-Image-2.1 è a pesi aperti e gira sul tuo hardware. Se preferisci scrivere un prompt e ricevere un'immagine, apri Qwen Image 3 su GoEnhance e parti da uno degli esempi qui sopra.

Inizia con Qwen Image 3