Qwen-Image-2.1

Qwen-Image-2.1 es el modelo de imagen de pesos abiertos del equipo Qwen, publicado el 20 de septiembre de 2026. Genera y edita en un solo modelo, produce imágenes RGBA transparentes de forma nativa, acepta hasta 10 imágenes de referencia y trabaja en 2K con un transformador de generación de 7B. GoEnhance todavía no aloja la 2.1, así que la consola de abajo abre Qwen Image 3, el modelo Qwen más reciente disponible aquí.
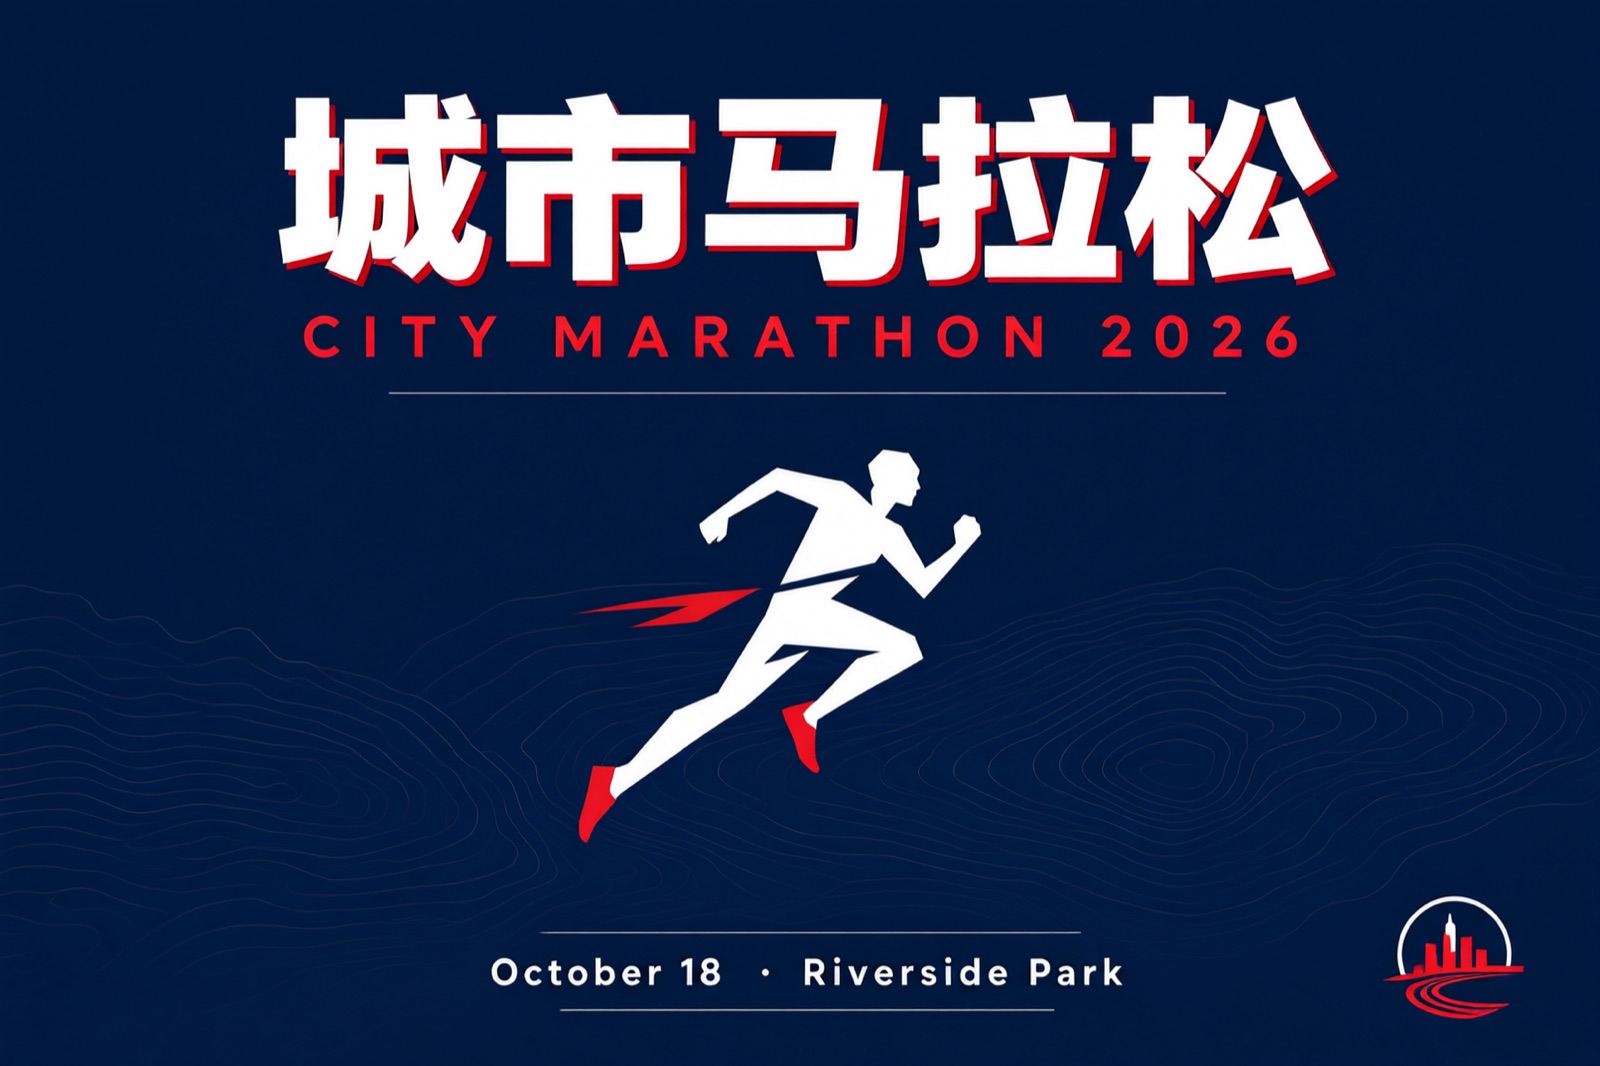
Tipografía de póster bilingüe
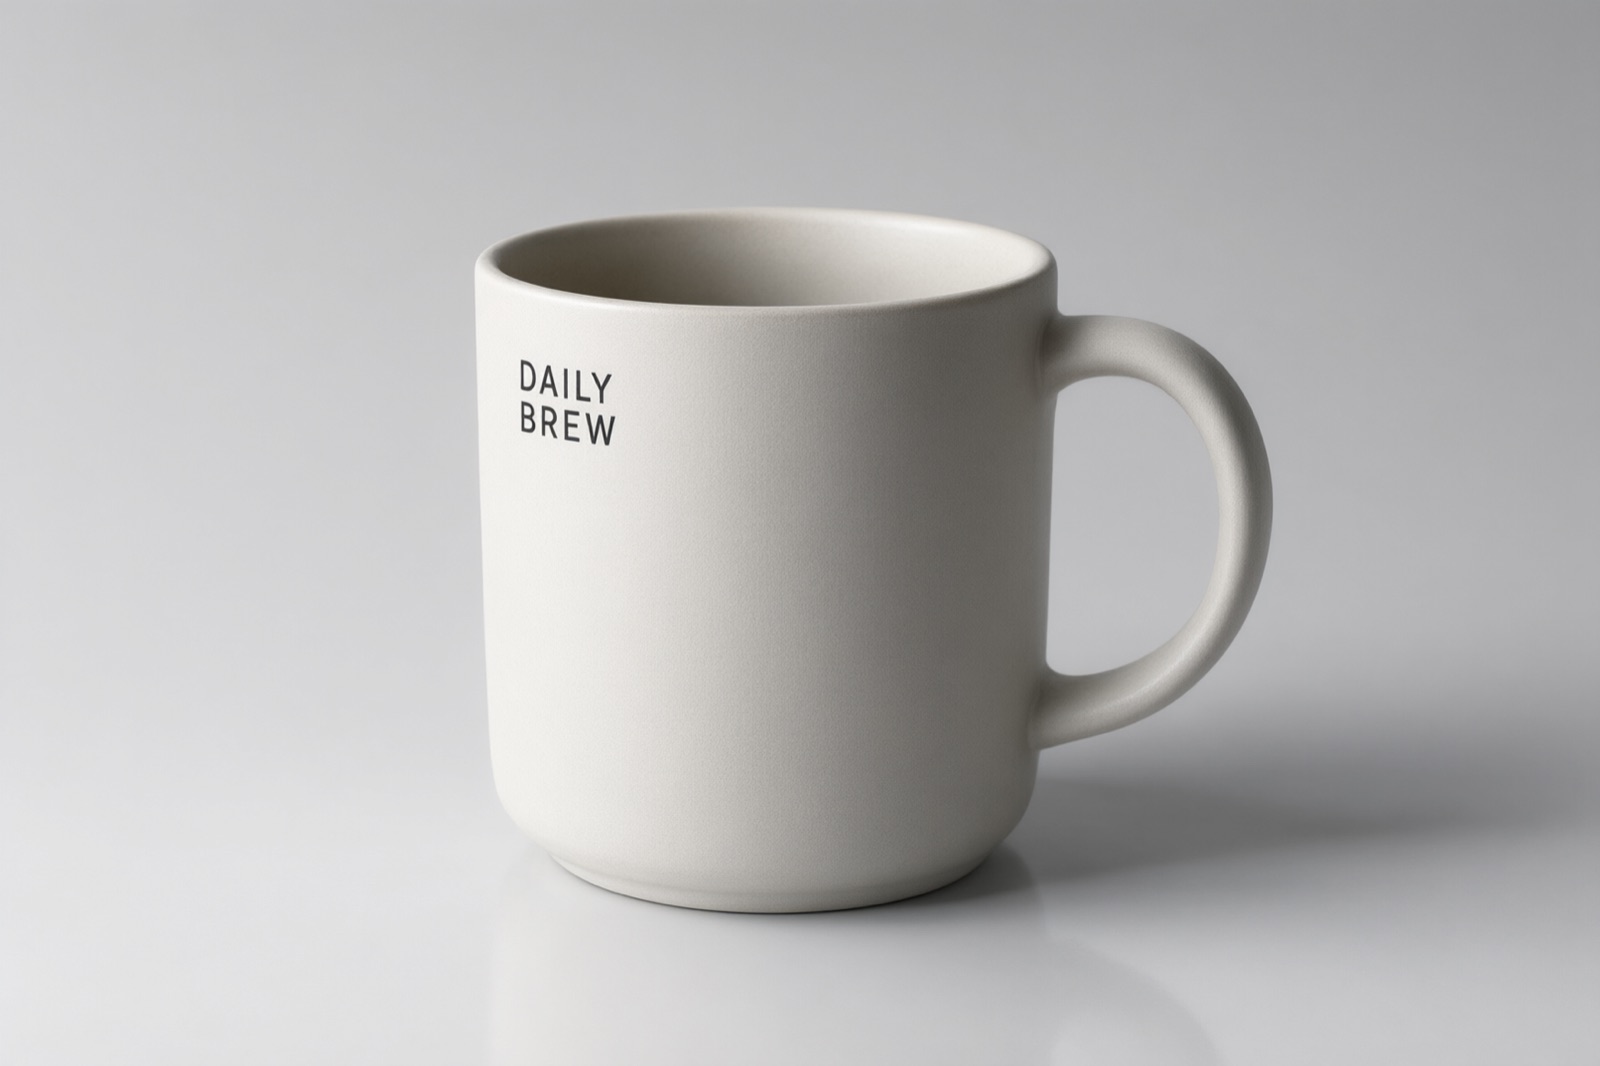
Foto de producto con etiqueta legible
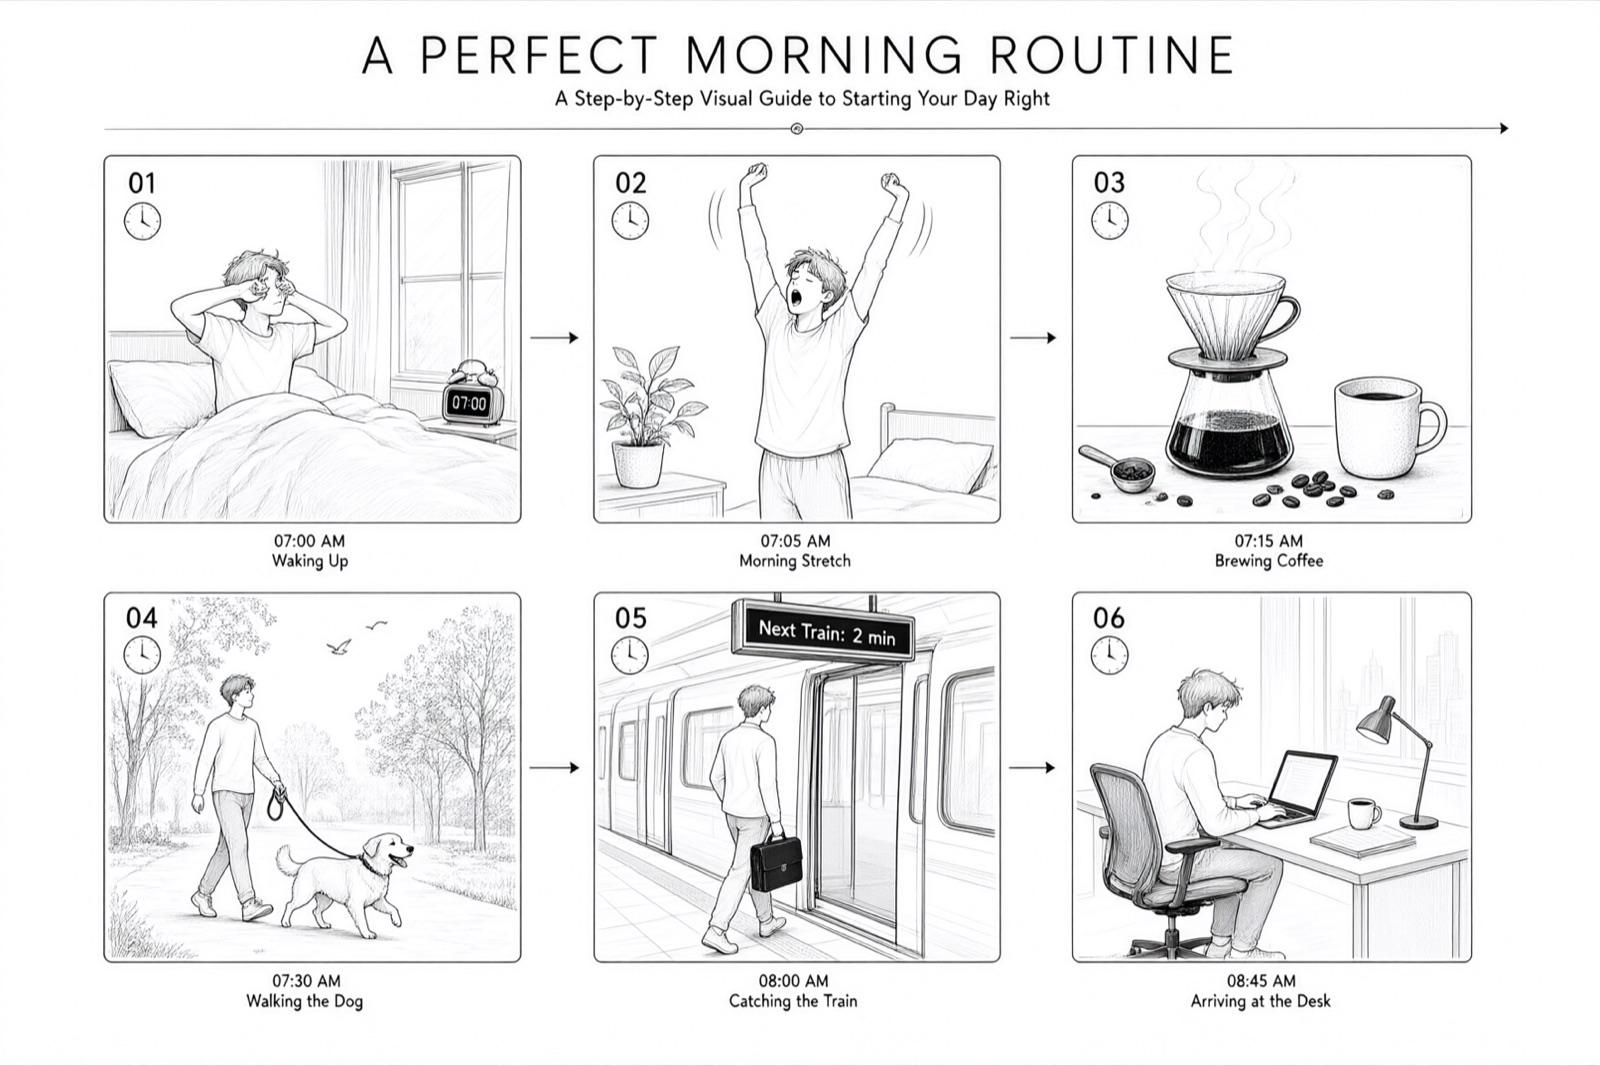
Storyboard de seis viñetas
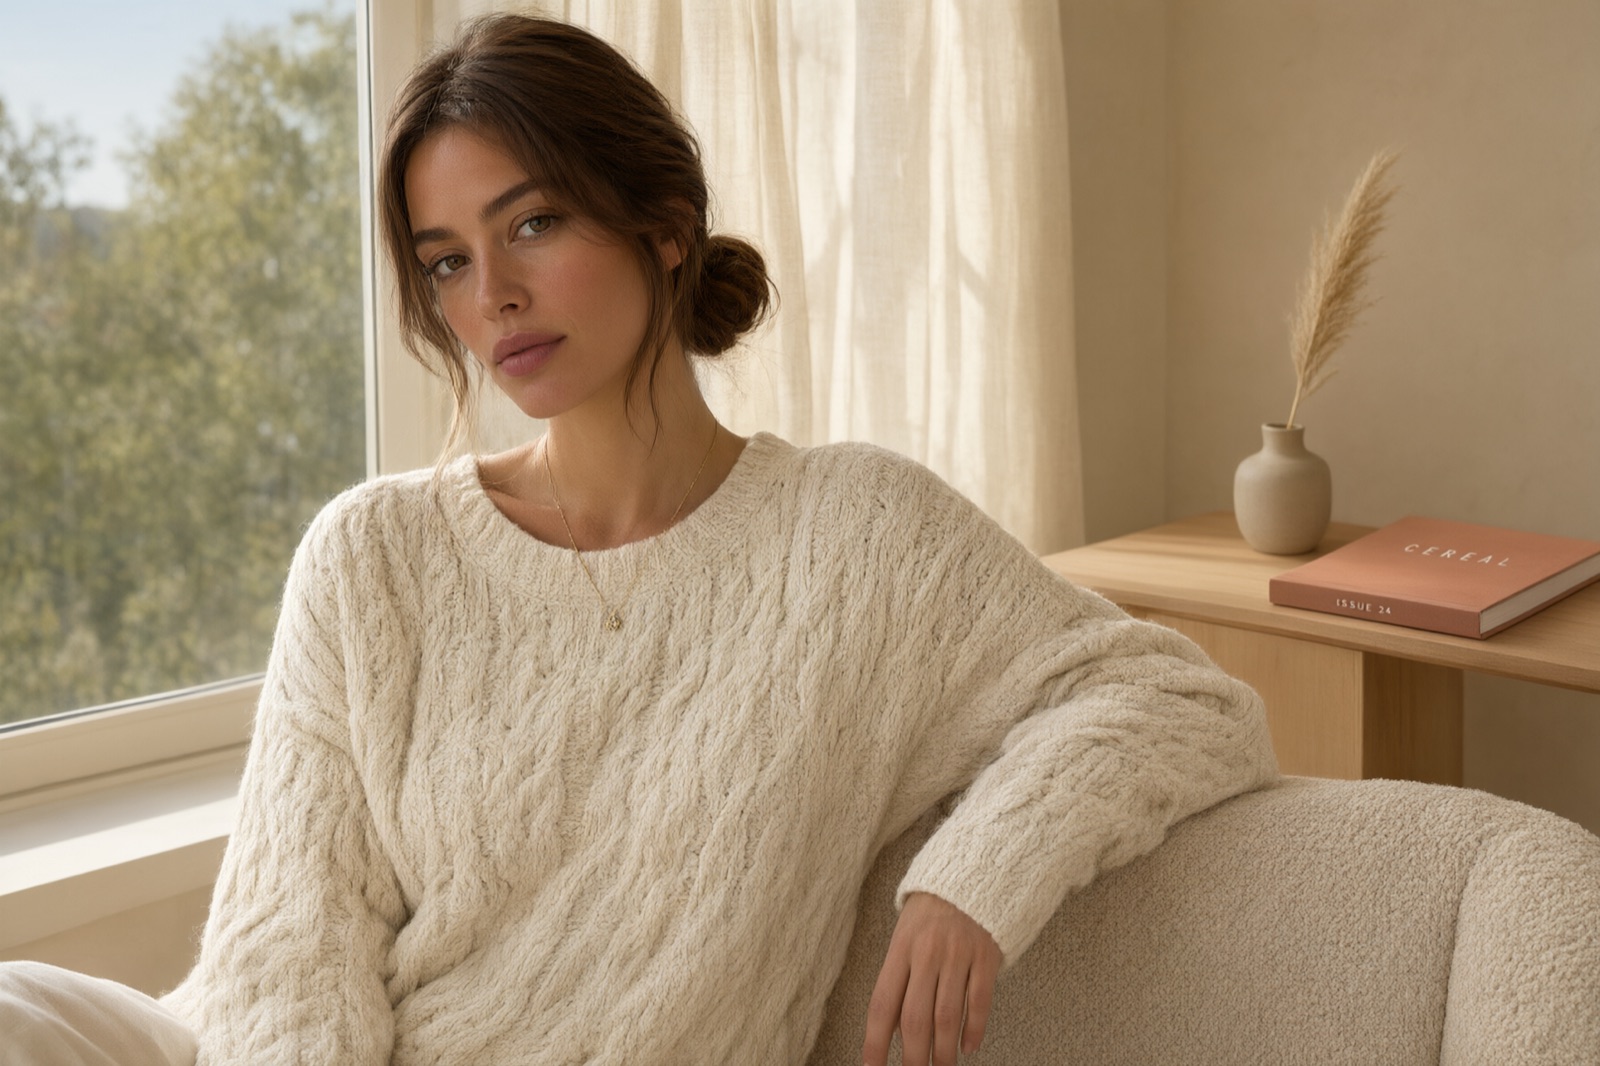
Retrato editorial
Retrato editorial
Qwen Image 3
Instrucción
Prompts de ejemplo
Abre el editor de GoEnhance con este modelo y prompt listos.

Lo que puedes crear con Qwen Image en GoEnhance

Pósteres cuyo texto aguanta

Coloca titulares, fechas y letra pequeña en inglés o chino y recibe un diseño donde las letras se sostienen. Sirve para carteles de eventos, key visuals y portadas sociales con texto real.

Pósteres cuyo texto aguanta

Fotos de producto con etiquetas legibles

Pon el producto sobre un fondo limpio, mantén la luz suave y la etiqueta nítida. Ideal para catálogos, fichas de tienda y bocetos de packaging.

Fotos de producto con etiquetas legibles

Tableros y cuadrículas de varias viñetas

Pide un tablero de seis viñetas, un explicativo de nueve casillas o una hoja de diseño: cada cuadro llega con el mismo estilo y los pies de foto donde los quieras.

Tableros y cuadrículas de varias viñetas

Retratos con piel y luz naturales

Genera retratos editoriales con textura de piel creíble, brillo en los ojos y luz suave de ventana, y luego itera el vestuario o el encuadre sin perder el rostro.

Retratos con piel y luz naturales

Novedades de Qwen-Image-2.1

Transparencia nativa, no un recorte

Qwen-Image-2.1 incorpora un autocodificador RGBA de 64 canales con compresión espacial 16x, así que la transparencia vive en el modelo y no en el posproceso: imágenes transparentes desde el prompt, edición de capas transparentes y extracción de sujetos de fotos normales.

Un modelo para generar y editar

La generación desde texto y la edición de imágenes usan la misma canalización. Puedes partir de un prompt, entregar una imagen para modificarla o hacer ambas cosas en una sola petición, sin cambiar de checkpoint.

Hasta 10 imágenes de referencia

Entrega hasta diez referencias en una edición: una foto de grupo a partir de retratos individuales, o un conjunto completo con tomas separadas de modelo, ropa, zapatos, bolso y sombrero.

Señala qué debe cambiar

Las ediciones locales se marcan con un círculo, una anotación pintada o una máscara aparte. El modelo conserva la identidad de personas y productos y solo cambia la zona marcada.

Arquitectura compacta de 7B

El transformador de generación son 32 capas DiT de flujo único con 7B de parámetros, junto a un codificador de texto Qwen3-VL de 8B. La atención de granularidad mixta y la reutilización de caché KV de prefijo codifican prompt y referencias una vez y las reutilizan en cada paso.

2K nativo y tipografía más nítida

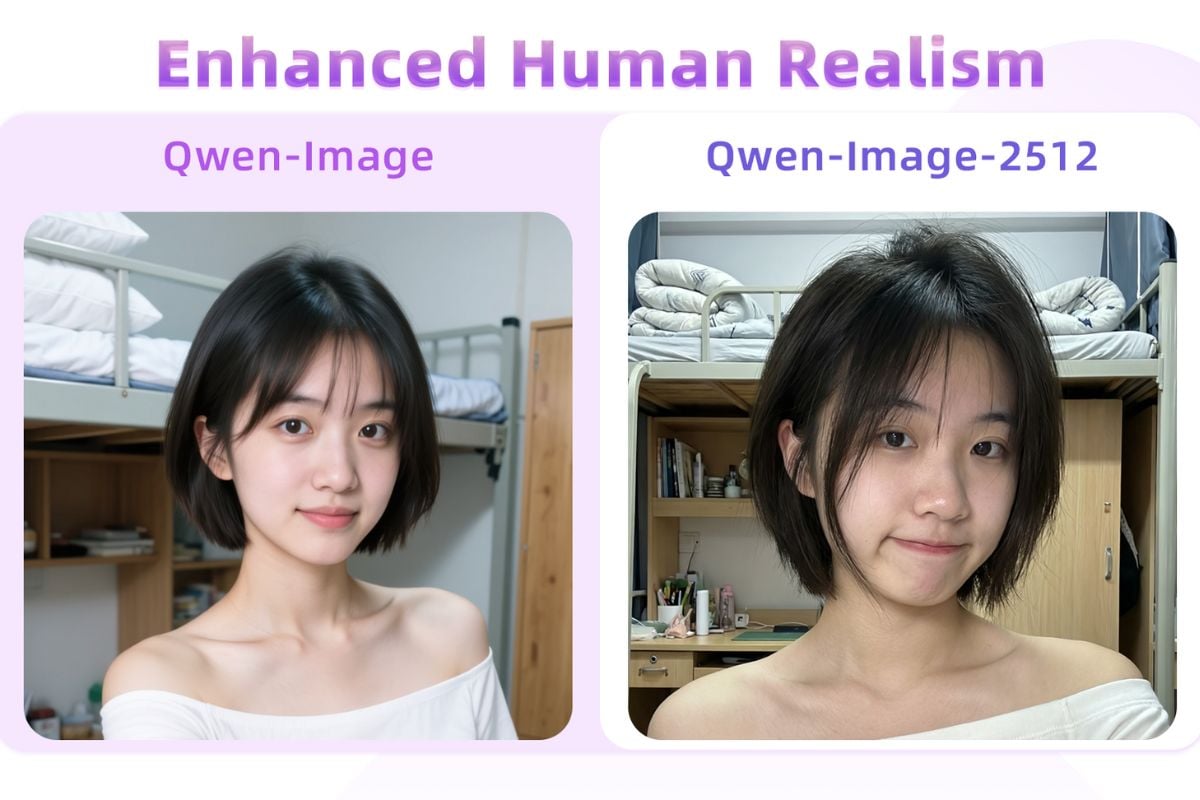
Los tamaños recomendados van de 2048x2048 en cuadrado a 2752x1536 en 16:9, con 40 pasos por defecto. La tipografía, la luz en retrato y las texturas finas mejoran respecto a la versión anterior de Qwen-Image.

Cómo ejecutar Qwen-Image-2.1 por tu cuenta

01

Consigue los pesos

Qwen-Image-2.1 es de pesos abiertos. Descárgalo desde Hugging Face (Qwen/Qwen-Image-2.1) o ModelScope, o toma la copia lista para ComfyUI en Comfy-Org/Qwen-Image-2.1.

02

Elige un runtime

Diffusers lo soporta desde el primer día con QwenImage21Pipeline y ComfyUI trae flujos nativos de generación y edición. Para cargas mayores, vLLM-Omni, SGLang y LightX2V añaden caché de prefijo, cuantización e inferencia multi-GPU; también hay soporte para AMD ROCm y chips FlagOS.

03

Prompt, tamaño y transparencia

Empieza por los checkpoints oficiales de reescritura de prompts (PE-T2I para generar, PE-I2I para editar), respeta los tamaños 2K recomendados y los 40 pasos, y para un resultado transparente abre el prompt con la fórmula RGBA que el modelo espera.

Qwen-Image-2.1 frente a Qwen Image en GoEnhance

AspectoQwen-Image-2.1 (pesos abiertos)Qwen Image 3 (aquí en GoEnhance)
Dónde se ejecutaTu propia GPU o un runtime en la nube que montes túEn el navegador, sin instalar nada
Salida RGBA transparenteNativa, incluida la edición de capas transparentesNo disponible
Imágenes de referenciaHasta 10 en una ediciónImagen de referencia admitida en el editor
Resolución2K nativo, hasta 2752x1536Salida en 1K y 2K
Representación de textoMejor tipografía en inglés y chinoTexto bilingüe sólido y composiciones densas
Para empezarDescargar pesos, instalar un runtime y gestionar tu GPUEscribir un prompt y generar

Preguntas frecuentes sobre Qwen-Image-2.1

¿Qué es Qwen-Image-2.1?

Qwen-Image-2.1 es un modelo de imagen de pesos abiertos del equipo Qwen que reúne generación desde texto y edición en un solo modelo. Su transformador de generación tiene 7B de parámetros en 32 capas DiT de flujo único y produce imágenes RGBA transparentes de forma nativa. Los pesos se publicaron el 20 de septiembre de 2026.

¿Puedo usar Qwen-Image-2.1 en GoEnhance?

Todavía no. GoEnhance ejecuta Qwen Image 2, Qwen Image 2 Pro, Qwen Image 3 y Qwen Image 3 Pro. La consola de esta página abre Qwen Image 3, el modelo Qwen más reciente disponible aquí, para probar la familia sin montar una GPU.

¿Es gratis para uso comercial?

El repositorio se publica bajo el Qwen Research License Agreement, que no equivale a una licencia comercial normal. Lee el texto de la licencia en el repositorio de GitHub antes de usar los pesos o los resultados en un proyecto comercial.

¿Cómo genera imágenes transparentes?

La transparencia está en el autocodificador: un VAE RGBA de 64 canales con compresión espacial 16x. La pides en el prompt, indicando que la imagen es RGBA con fondo transparente, y recibes un canal alfa real en lugar de un recorte.

¿Qué hardware necesito?

Es un modelo de generación de 7B con un codificador de texto de 8B, así que en la práctica necesitas una GPU moderna con suficiente VRAM. Los runtimes de la comunidad ayudan: vLLM-Omni y SGLang ofrecen pesos FP8, descarga a CPU y paralelismo multi-GPU, y LightX2V apunta a tarjetas de consumo.

¿Cuántas imágenes de referencia acepta?

Hasta diez en una edición. Eso hace práctica la composición con varios sujetos: varias personas en una escena o un conjunto de ropa armado con fotos de producto separadas, manteniendo cada elemento reconocible.

Prueba la familia Qwen Image en GoEnhance

Qwen-Image-2.1 es de pesos abiertos y se ejecuta en tu propio hardware. Si prefieres escribir un prompt y recibir la imagen, abre Qwen Image 3 en GoEnhance y parte de uno de los ejemplos de arriba.

Empezar con Qwen Image 3