Qwen-Image-2.1
Qwen-Image-2.1 は Qwen チームが2026年9月20日に公開したオープンウェイトの画像モデルです。生成と編集を1つのモデルで行い、透過(RGBA)画像をネイティブに出力し、参照画像を最大10枚まで受け取り、7Bの生成トランスフォーマーで2K解像度に対応します。GoEnhance ではまだ 2.1 を提供していないため、下のコンソールは当サイトで利用できる最新の Qwen モデル「Qwen Image 3」を開きます。
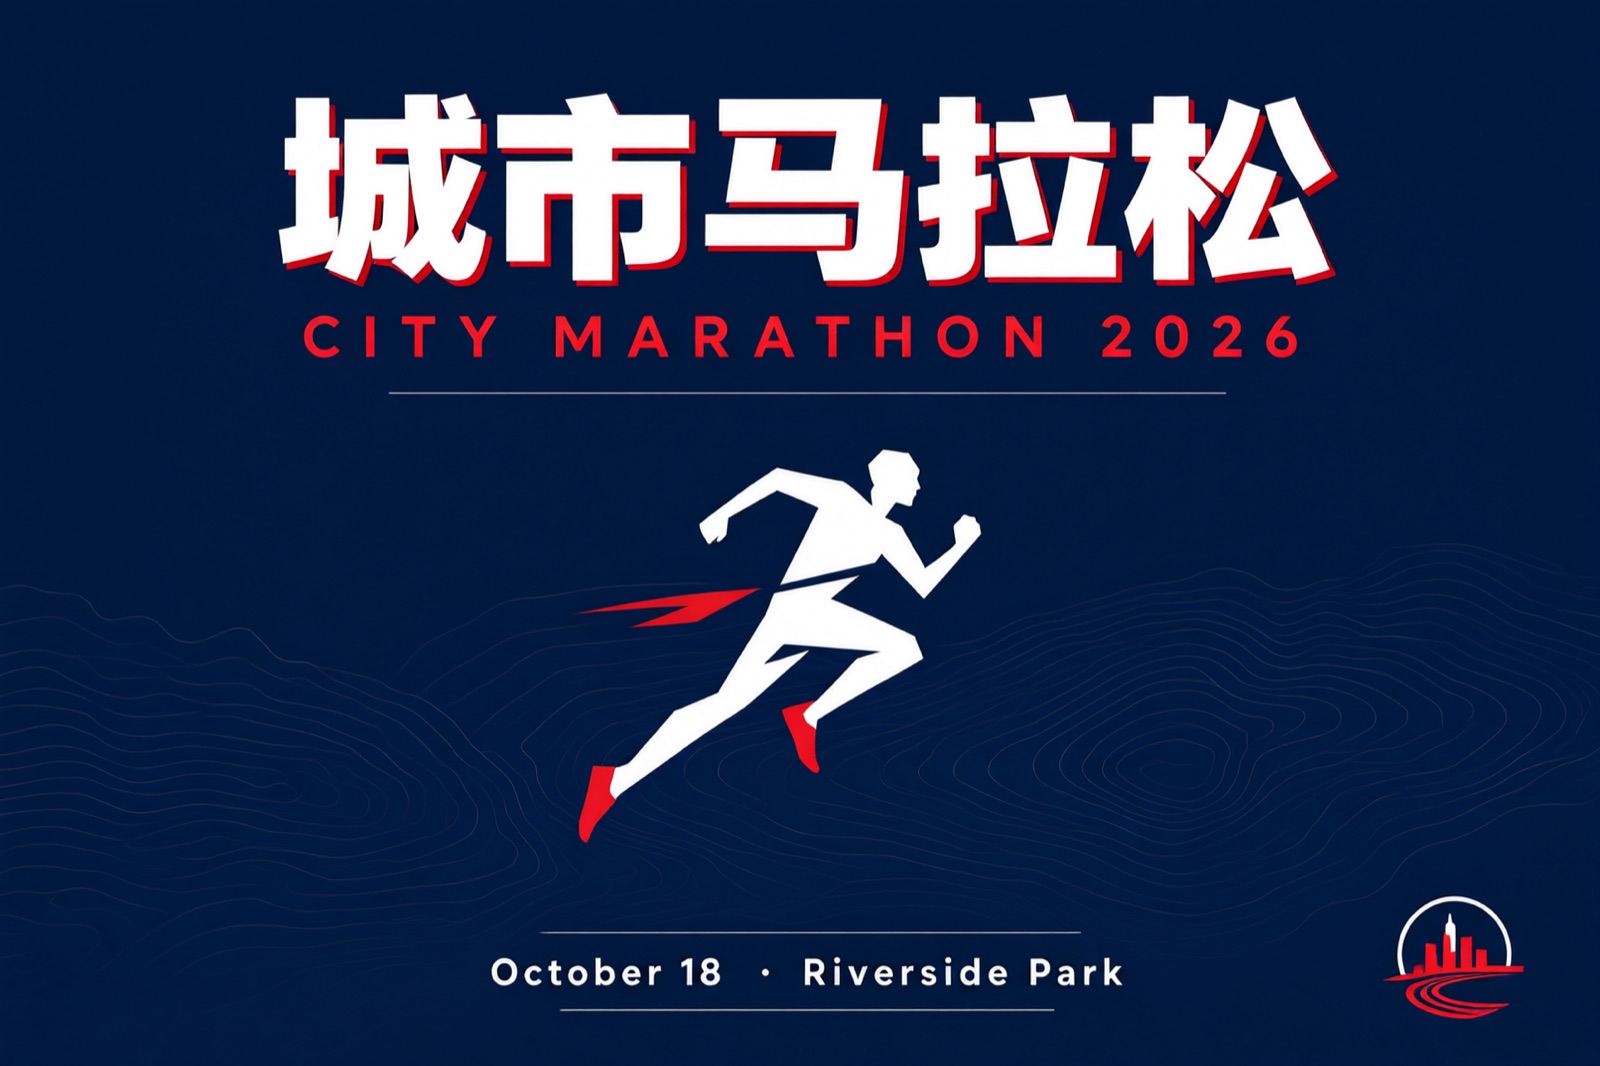
二言語ポスターのタイポグラフィ
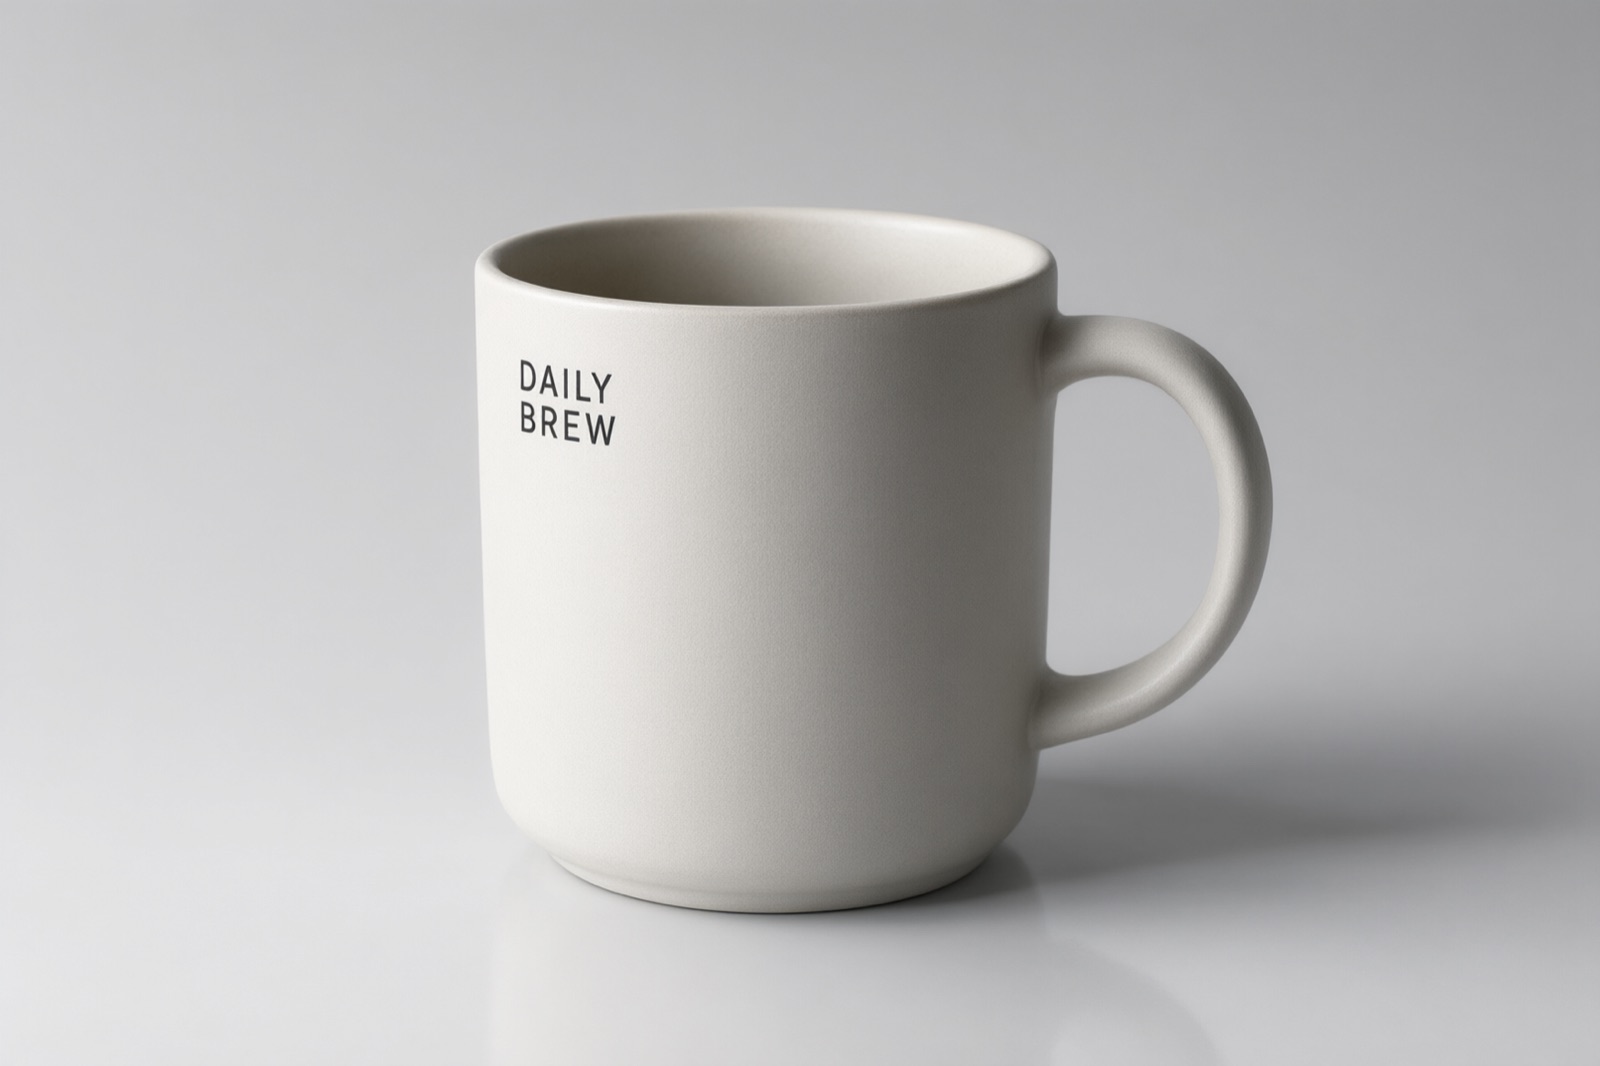
ラベルが読める商品写真
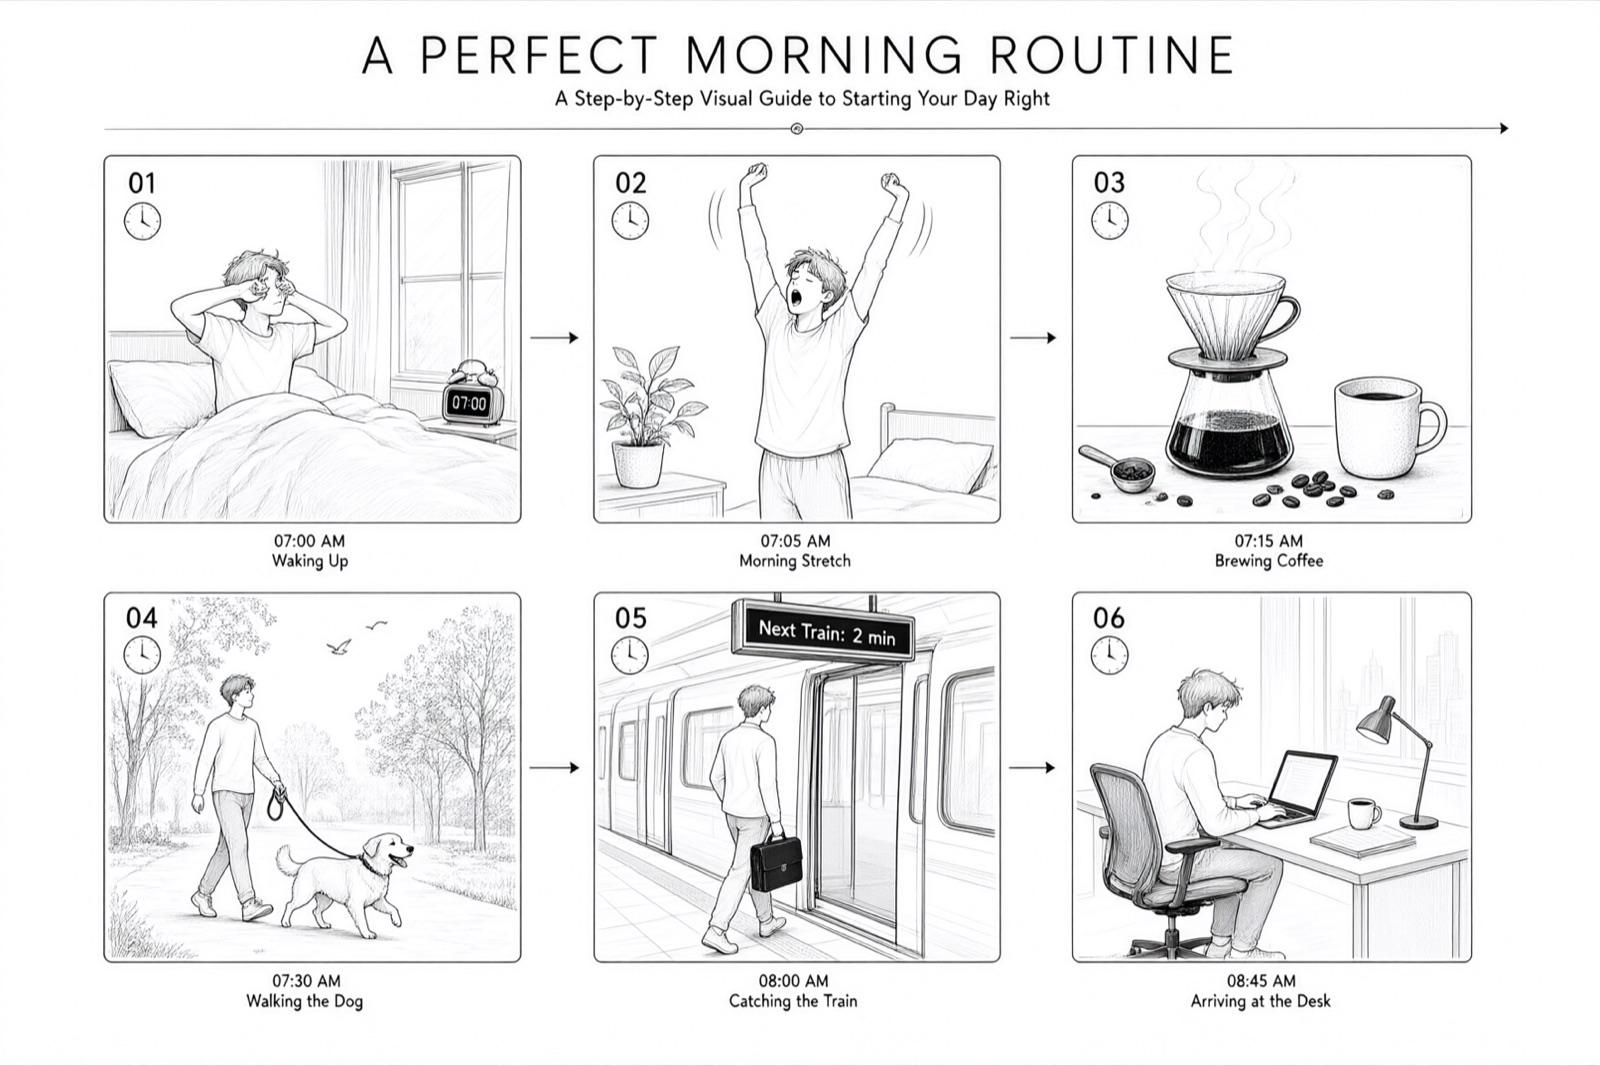
6コマのストーリーボード
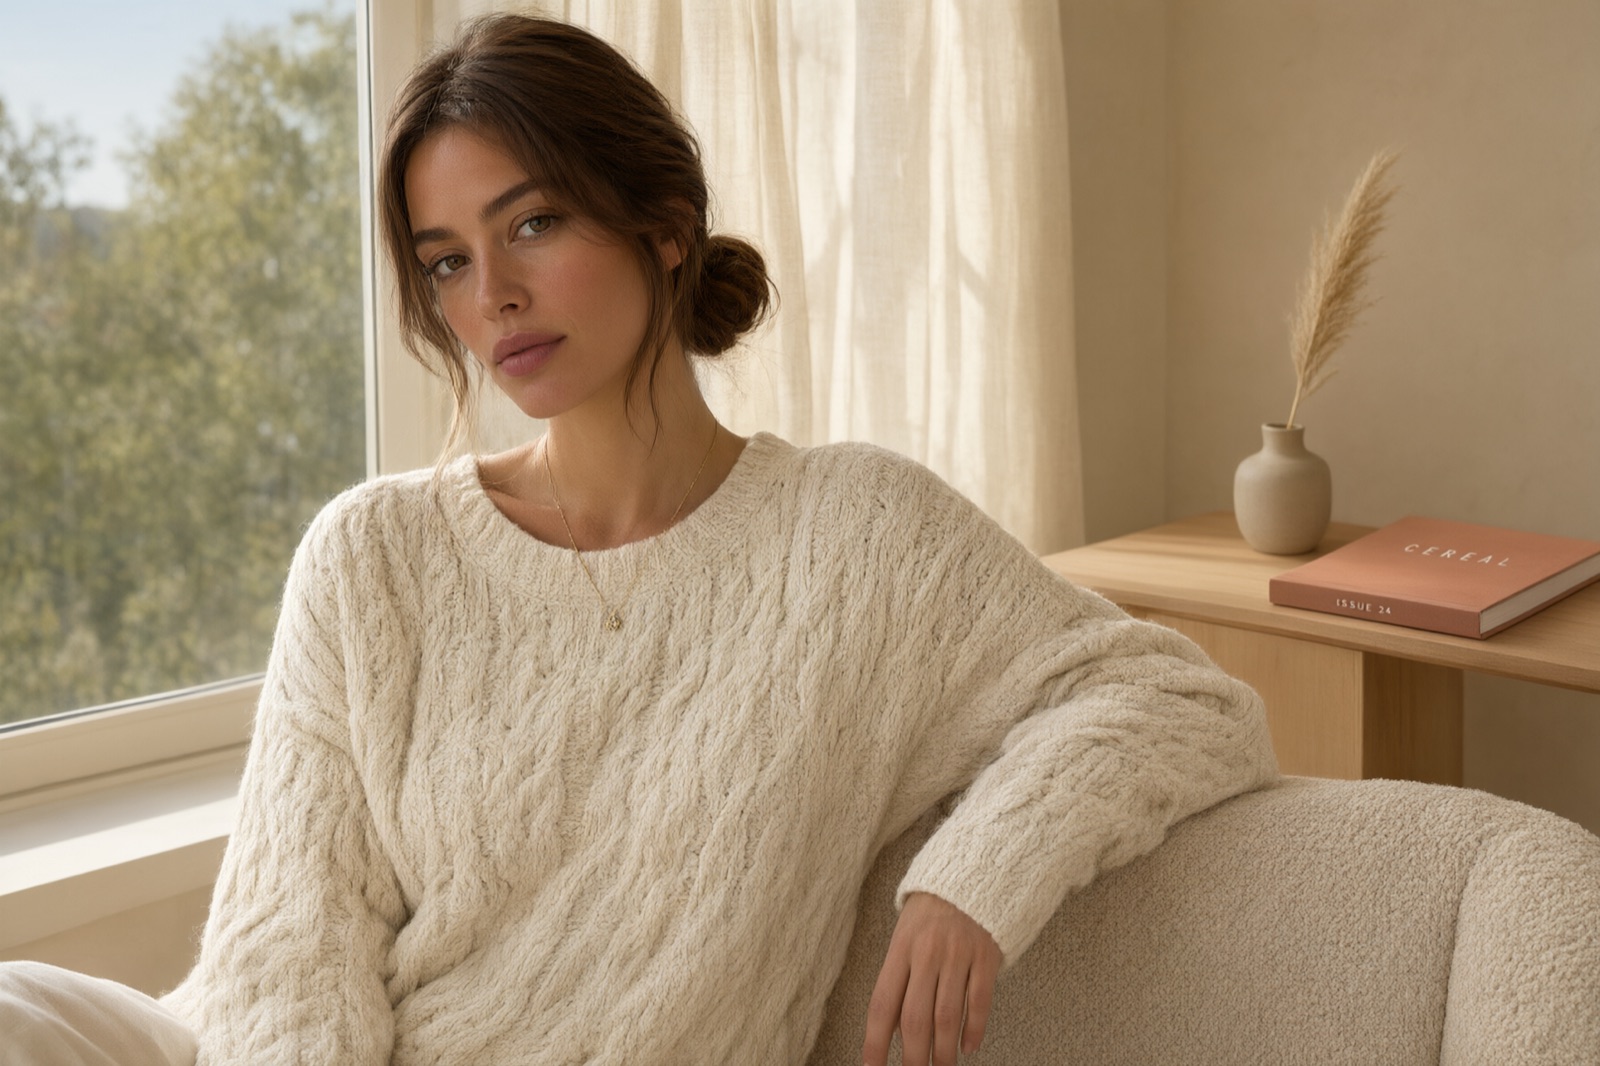
エディトリアルポートレート
Qwen Image 3
プロンプト
プロンプト例
このモデルとプロンプトを設定した状態で GoEnhance の作成画面を開きます。
GoEnhance の Qwen Image でつくれるもの
Qwen-Image-2.1 の新しい点
切り抜きではない、ネイティブ透過
64チャンネルのRGBAオートエンコーダ(空間圧縮16倍)を備え、透過は後処理ではなくモデル自体の機能です。プロンプトから透過画像を生成し、透過レイヤーを編集し、通常の写真から被写体を抜き出せます。
生成と編集が1つのモデル
テキストからの生成と画像編集が同じパイプラインを通ります。プロンプトから始めても、変更したい画像を渡しても、1回のリクエストで両方を行っても、チェックポイントの切り替えは不要です。
参照画像は最大10枚
1回の編集で最大10枚の参照を渡せます。個別のポートレートから集合写真を作る、モデル・服・靴・バッグ・帽子の別々の写真から一式のコーディネートを組み上げる、といった使い方ができます。
変える場所を指し示す
部分的な編集は、丸で囲む・手描きの注記・別マスクのいずれかで指定します。人物や商品の同一性は保ったまま、指定した範囲だけが変わります。
7B のコンパクトな構成
生成トランスフォーマーは32層のシングルストリームDiTで7Bパラメータ、テキストエンコーダは Qwen3-VL 8B。混合粒度アテンションとプレフィックスKVキャッシュの再利用により、プロンプトと参照画像は一度だけエンコードされ、以降のステップで再利用されます。
ネイティブ2Kと、より鮮明な文字
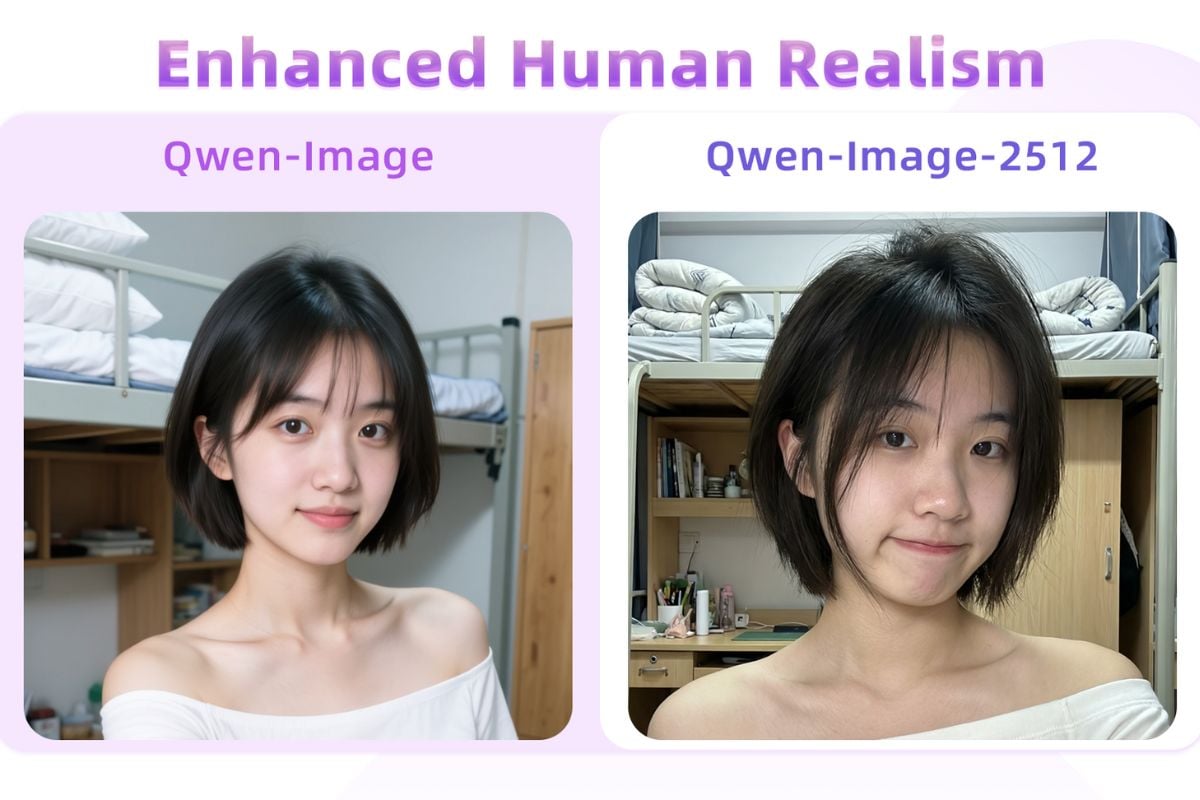
推奨サイズは正方形の2048×2048から16:9の2752×1536まで、デフォルトは40ステップです。文字組み、ポートレートの光、細部の質感が従来の Qwen-Image より向上しています。
Qwen-Image-2.1 を自分で動かす手順
01
重みを入手する
Qwen-Image-2.1 はオープンウェイトです。Hugging Face(Qwen/Qwen-Image-2.1)か ModelScope から取得するか、ComfyUI 向けに整えられた Comfy-Org/Qwen-Image-2.1 を使います。
02
実行環境を選ぶ
Diffusers は QwenImage21Pipeline で初日から対応し、ComfyUI にも生成・編集のネイティブワークフローがあります。負荷の高い用途には vLLM-Omni、SGLang、LightX2V がプレフィックスキャッシュ・量子化・マルチGPU推論を提供し、AMD ROCm や FlagOS 対応チップでも動きます。
03
プロンプト・サイズ・透過
公式のプロンプト書き換えモデル(生成は PE-T2I、編集は PE-I2I)から始め、推奨の2Kサイズと40ステップを守ります。透過が必要な場合は、モデルが想定するRGBAの書き出しでプロンプトを始めてください。
Qwen-Image-2.1 と GoEnhance の Qwen Image の比較
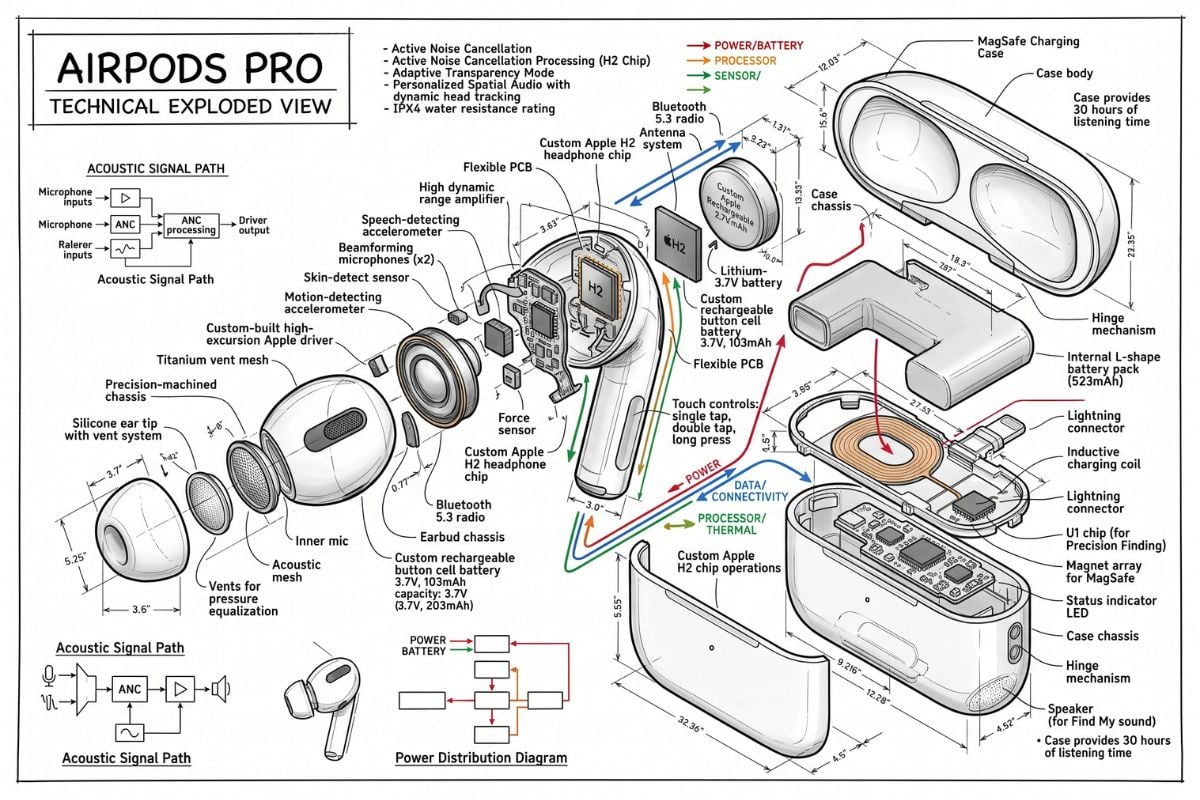
Qwen-Image-2.1 のよくある質問
Qwen-Image-2.1 とは?
GoEnhance で Qwen-Image-2.1 を使えますか?
商用利用は無料ですか?
透過画像はどう生成されますか?
どんなハードウェアが必要ですか?
参照画像は何枚まで使えますか?
GoEnhance で Qwen Image シリーズを試す
Qwen-Image-2.1 はオープンウェイトで、自前の環境で動かすモデルです。プロンプトを書いて画像を受け取りたい場合は、GoEnhance で Qwen Image 3 を開き、上の例のどれかから始めてください。
Qwen Image 3 で始める