Qwen-Image-2.1

Qwen-Image-2.1 ist das offene Bildmodell des Qwen-Teams, veröffentlicht am 20. September 2026. Es erzeugt und bearbeitet Bilder in einem Modell, gibt transparente RGBA-Bilder nativ aus, verarbeitet bis zu 10 Referenzbilder und arbeitet in 2K mit einem 7B-Generierungstransformer. Auf GoEnhance läuft 2.1 noch nicht – die Konsole unten nutzt Qwen Image 3, das neueste hier verfügbare Qwen-Modell.
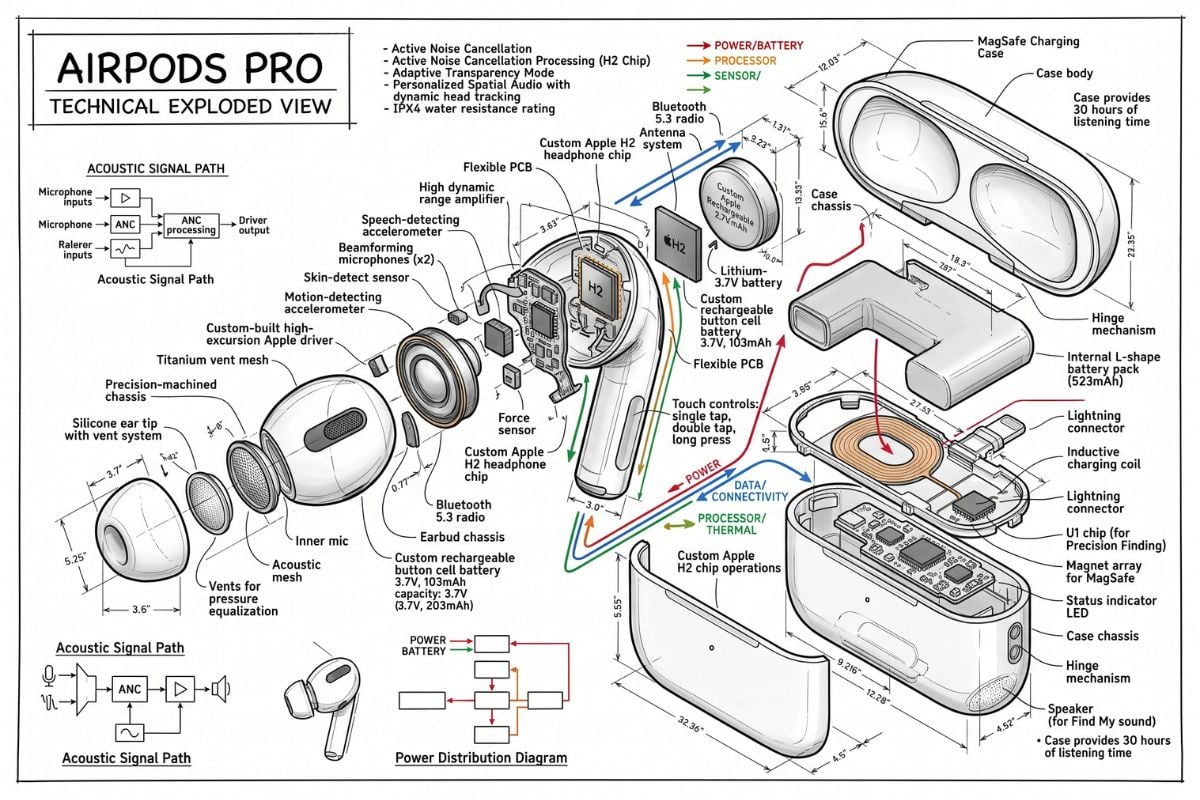
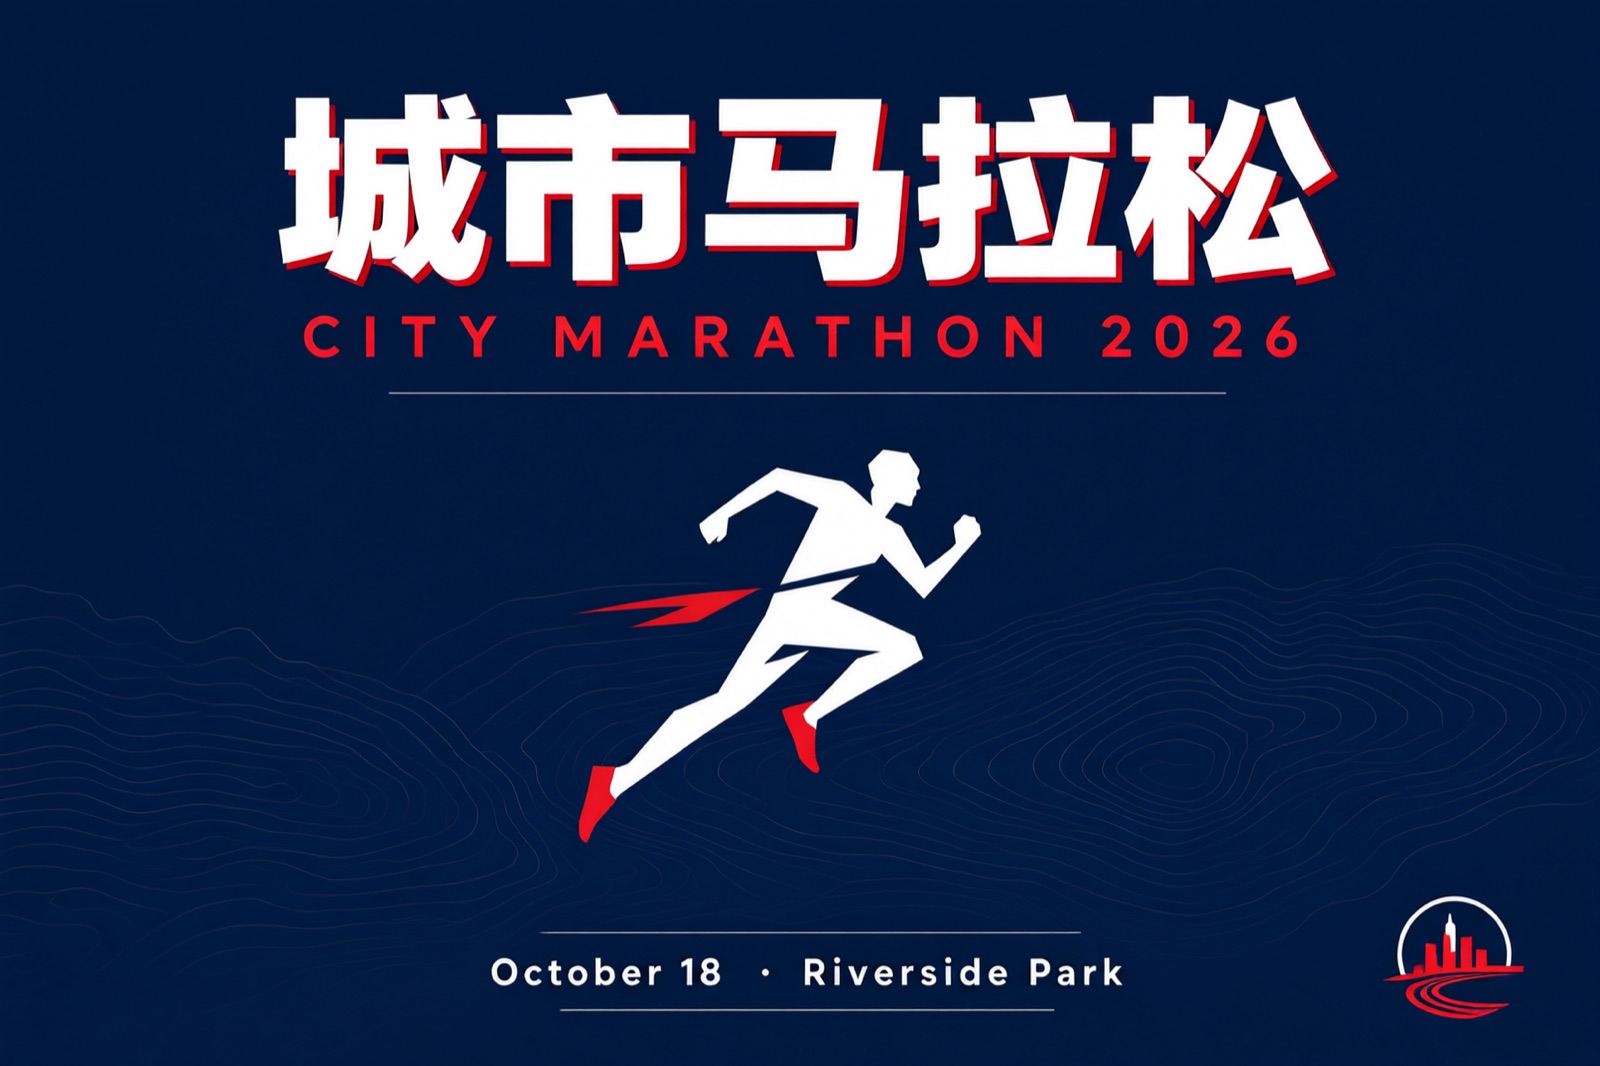
Zweisprachige Plakat-Typografie
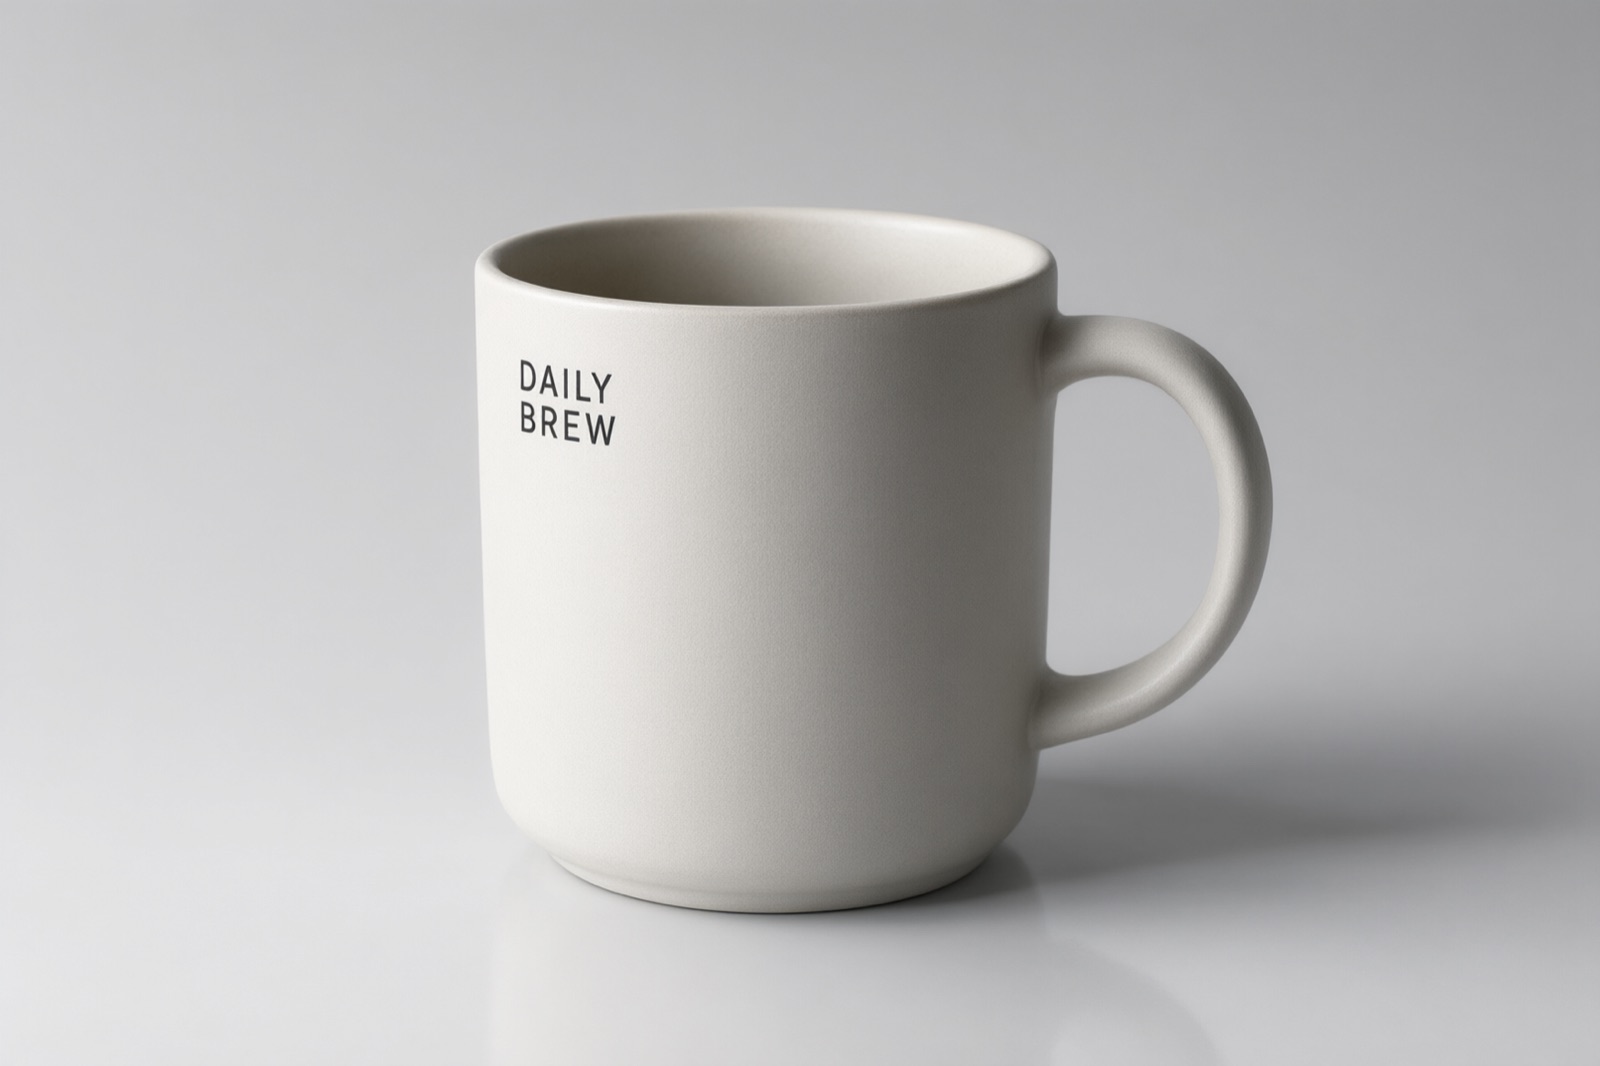
Produktfoto mit lesbarem Etikett
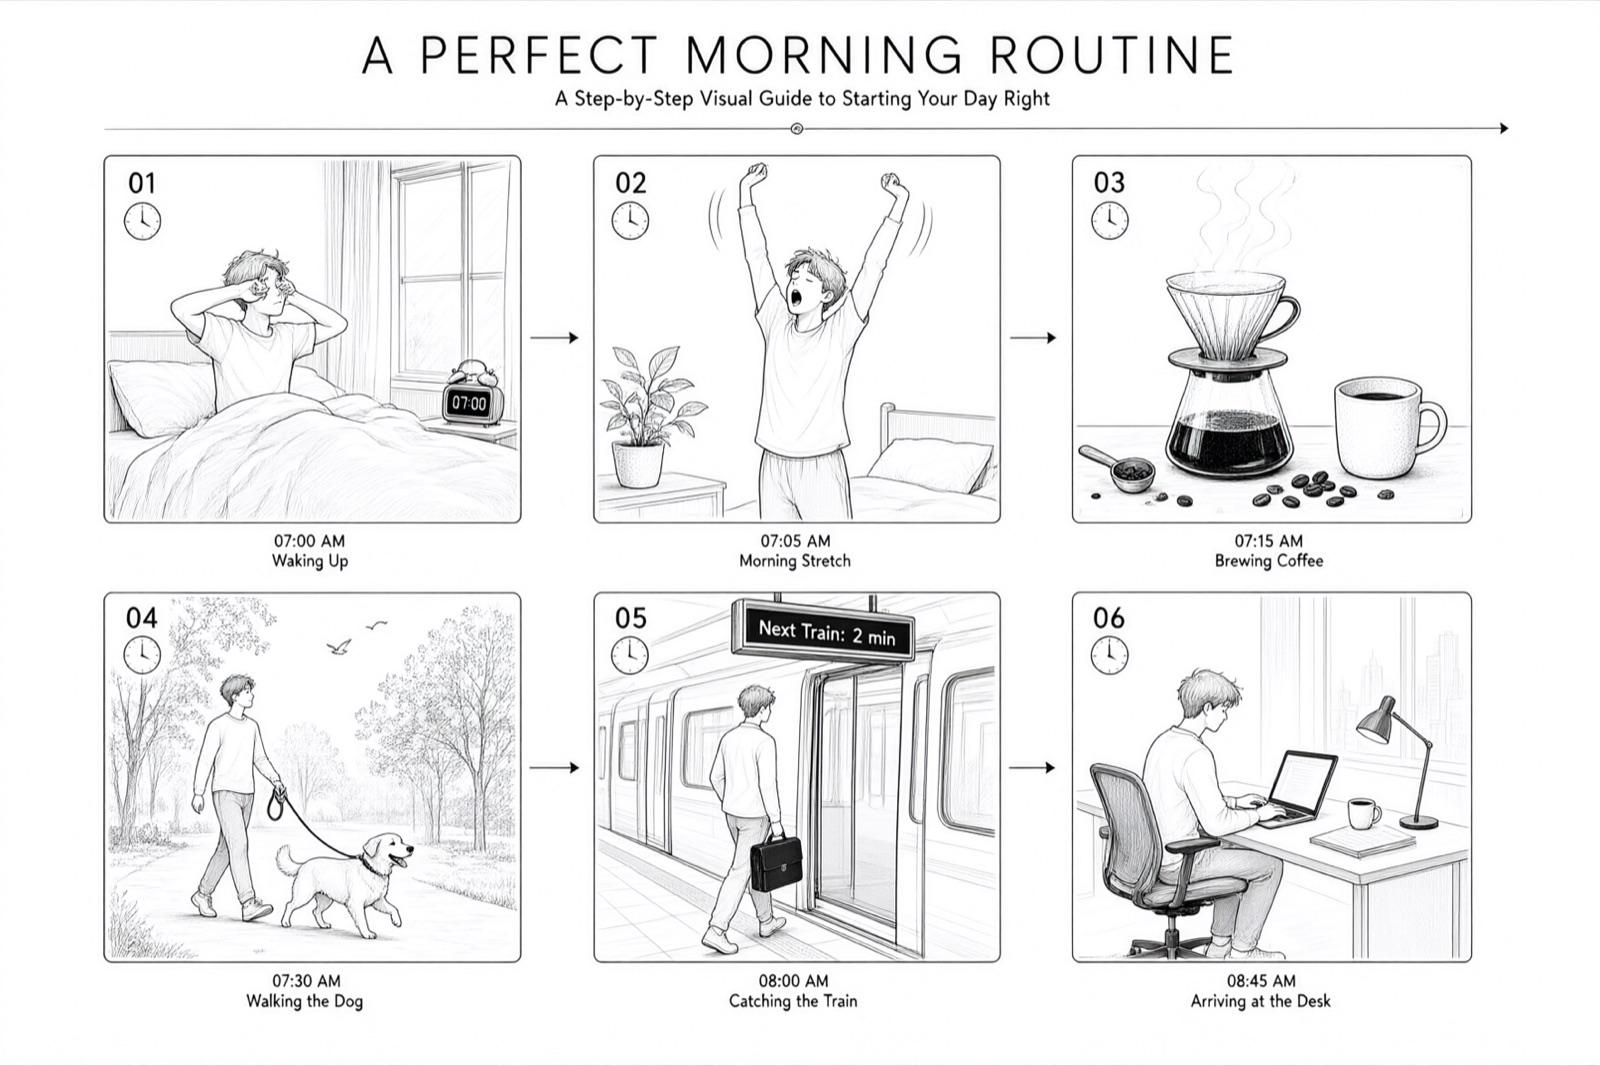
Sechs-Panel-Storyboard
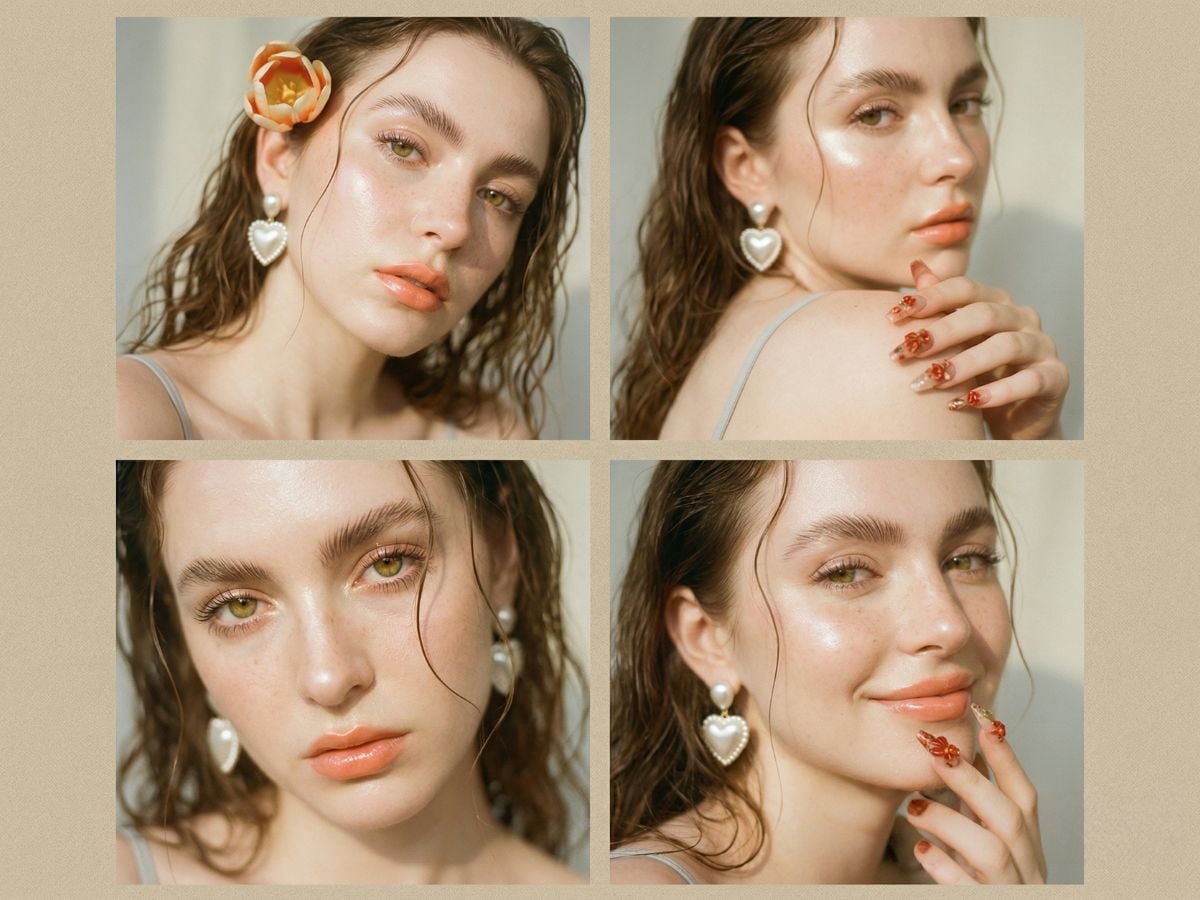
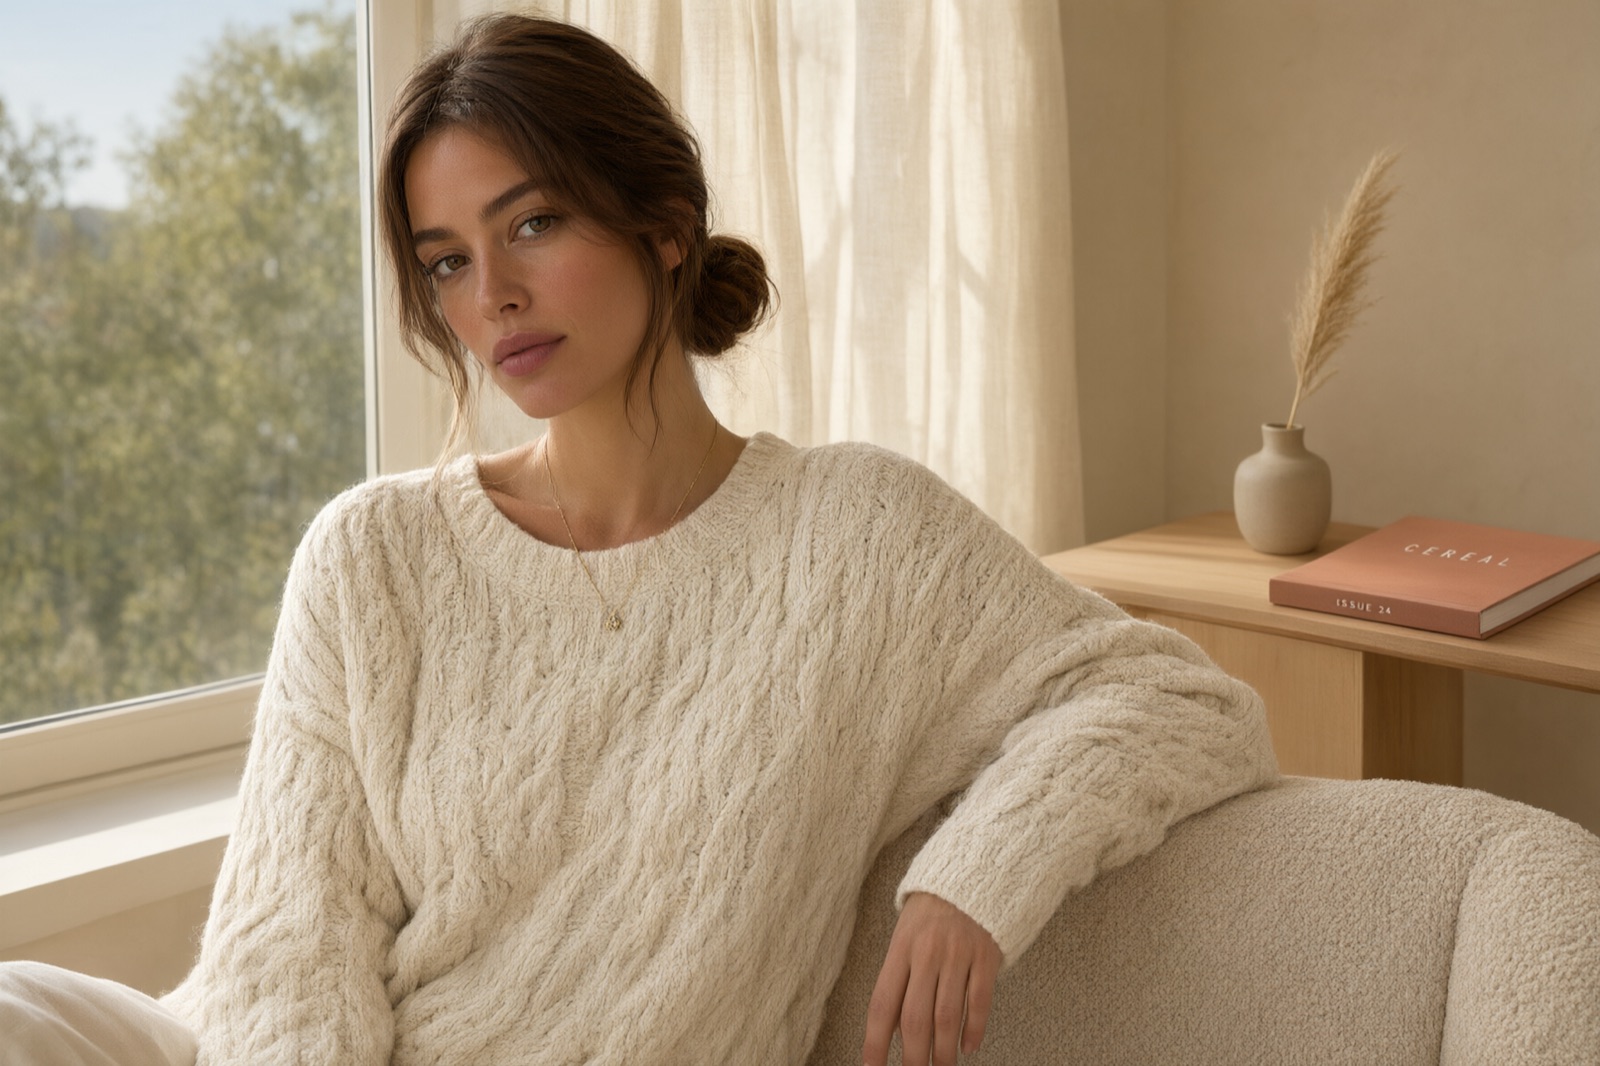
Editorial-Porträt
Editorial-Porträt
Qwen Image 3
Prompt
Beispiel-Prompts
Öffnet den GoEnhance-Editor mit diesem Modell und Prompt.

Was du mit Qwen Image auf GoEnhance machen kannst

Plakate, deren Text hält

Setze Überschriften, Daten und Kleingedrucktes auf Englisch oder Chinesisch und bekomme ein Design zurück, in dem die Buchstaben stehen bleiben. Gut für Event-Plakate, Key Visuals und Social-Cover mit echtem Text.

Plakate, deren Text hält

Produktfotos mit lesbaren Etiketten

Stelle ein Produkt vor einen sauberen Hintergrund, halte das Licht weich und das Etikett lesbar. Passend für Katalogbilder, Shop-Fotos und Verpackungsentwürfe.

Produktfotos mit lesbaren Etiketten

Mehrteilige Boards und Raster

Frag nach einem Sechs-Panel-Board, einem Neun-Felder-Explainer oder einem Design-Sheet – jedes Feld kommt im gleichen Stil, mit Bildunterschriften an der richtigen Stelle.

Mehrteilige Boards und Raster

Porträts mit natürlicher Haut und Licht

Erzeuge Editorial-Porträts mit glaubwürdiger Hauttextur, Lichtreflexen in den Augen und weichem Fensterlicht und iteriere über Outfit oder Bildausschnitt, ohne das Gesicht zu verlieren.

Porträts mit natürlicher Haut und Licht

Das ist neu in Qwen-Image-2.1

Echte Transparenz statt Freistellen

Qwen-Image-2.1 bringt einen 64-Kanal-RGBA-Autoencoder mit 16-facher räumlicher Kompression mit. Transparenz steckt im Modell statt in der Nachbearbeitung: transparente Bilder aus dem Prompt, Bearbeitung transparenter Ebenen und Freistellen von Motiven aus normalen Fotos.

Ein Modell für Erzeugen und Bearbeiten

Text-zu-Bild und Bildbearbeitung laufen über dieselbe Pipeline. Du startest mit einem Prompt, übergibst ein Bild zum Ändern oder beides in einer Anfrage – ohne Checkpoint-Wechsel.

Bis zu 10 Referenzbilder

Übergib bis zu zehn Referenzen in einer Bearbeitung: ein Gruppenfoto aus einzelnen Porträts oder ein komplettes Outfit aus getrennten Aufnahmen von Model, Kleidung, Schuhen, Tasche und Hut.

Zeig, was sich ändern soll

Lokale Änderungen markierst du mit einem Kreis, einer gemalten Notiz oder einer separaten Maske. Personen und Produkte behalten ihre Identität, geändert wird nur der markierte Bereich.

Kompakte 7B-Architektur

Der Generierungstransformer besteht aus 32 Single-Stream-DiT-Schichten mit 7B Parametern, dazu kommt ein Qwen3-VL-8B-Textencoder. Mixed-Granularity-Attention und Prefix-KV-Cache kodieren Prompt und Referenzbilder einmal und nutzen sie über alle Schritte wieder.

Natives 2K und schärfere Schrift

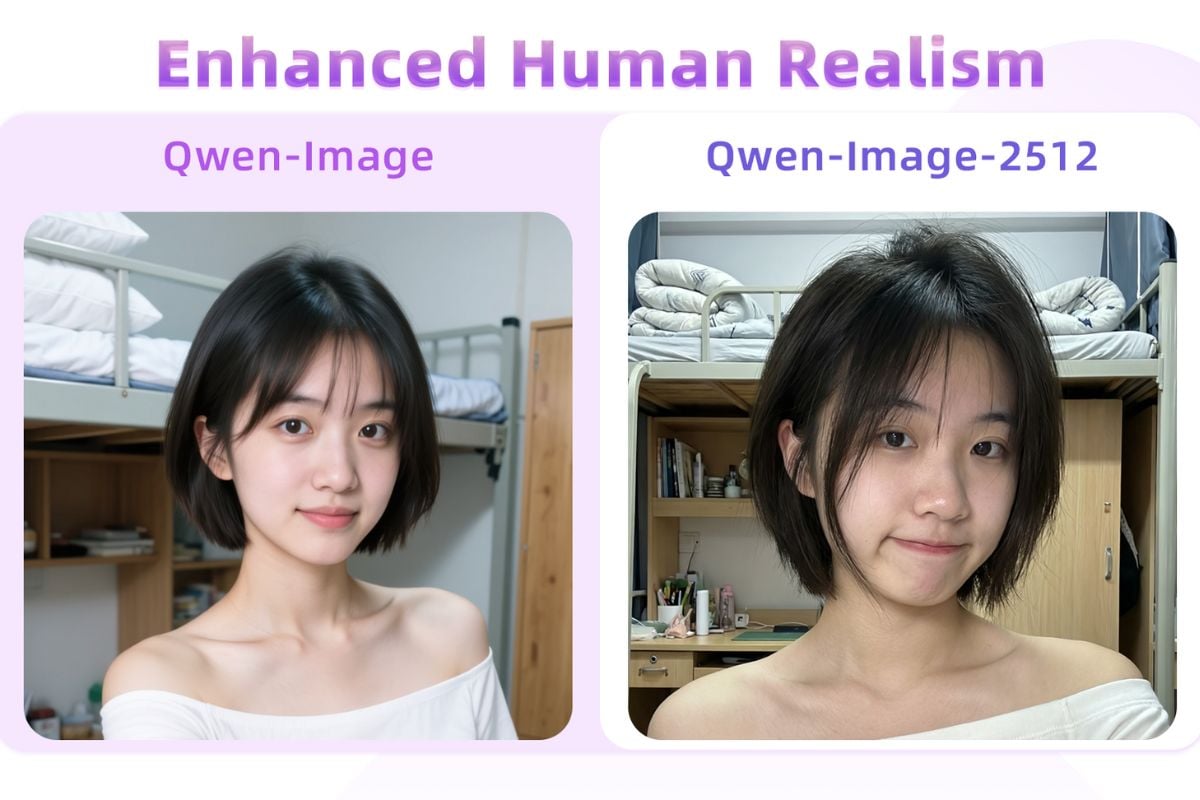
Empfohlene Größen reichen von 2048x2048 im Quadrat bis 2752x1536 in 16:9, standardmäßig mit 40 Schritten. Typografie, Porträtlicht und feine Texturen sind besser als in der vorherigen Qwen-Image-Version.

Qwen-Image-2.1 selbst betreiben

01

Gewichte holen

Qwen-Image-2.1 ist offen. Lade es von Hugging Face (Qwen/Qwen-Image-2.1) oder ModelScope – oder die ComfyUI-fertige Fassung von Comfy-Org/Qwen-Image-2.1.

02

Runtime wählen

Diffusers unterstützt es ab Tag eins über QwenImage21Pipeline, ComfyUI bringt native Workflows für Erzeugen und Bearbeiten mit. Für größere Lasten bieten vLLM-Omni, SGLang und LightX2V Prefix-Caching, Quantisierung und Multi-GPU-Inferenz; AMD ROCm und FlagOS-Chips werden ebenfalls unterstützt.

03

Prompt, Größe, Transparenz

Starte mit den offiziellen Prompt-Rewriting-Checkpoints (PE-T2I zum Erzeugen, PE-I2I zum Bearbeiten), bleib bei den empfohlenen 2K-Größen und 40 Schritten und beginne den Prompt für ein transparentes Ergebnis mit der RGBA-Formulierung, die das Modell erwartet.

Qwen-Image-2.1 im Vergleich zu Qwen Image auf GoEnhance

KriteriumQwen-Image-2.1 (offene Gewichte)Qwen Image 3 (hier auf GoEnhance)
Wo es läuftEigene GPU oder eine selbst eingerichtete Cloud-RuntimeIm Browser, ohne Installation
Transparente RGBA-AusgabeNativ, inklusive Bearbeitung transparenter EbenenNicht verfügbar
ReferenzbilderBis zu 10 pro BearbeitungReferenzbild im Editor möglich
AuflösungNatives 2K, bis 2752x15361K- und 2K-Ausgabe
TextdarstellungBessere Typografie auf Englisch und ChinesischStarker zweisprachiger Text und dichte Layouts
EinstiegGewichte laden, Runtime installieren, eigene GPU betreibenPrompt schreiben und generieren

Häufige Fragen zu Qwen-Image-2.1

Was ist Qwen-Image-2.1?

Qwen-Image-2.1 ist ein offenes Bildmodell des Qwen-Teams, das Text-zu-Bild und Bildbearbeitung in einem Modell vereint. Der Generierungstransformer hat 7B Parameter in 32 Single-Stream-DiT-Schichten und erzeugt transparente RGBA-Bilder nativ. Die Gewichte wurden am 20. September 2026 veröffentlicht.

Kann ich Qwen-Image-2.1 auf GoEnhance nutzen?

Noch nicht. Auf GoEnhance laufen derzeit Qwen Image 2, Qwen Image 2 Pro, Qwen Image 3 und Qwen Image 3 Pro. Die Konsole auf dieser Seite öffnet Qwen Image 3, das neueste hier verfügbare Qwen-Modell – so testest du die Familie ohne eigene GPU.

Ist Qwen-Image-2.1 für kommerzielle Arbeit frei?

Das Repository steht unter dem Qwen Research License Agreement, das keine einfache kommerzielle Lizenz ist. Lies den Lizenztext im GitHub-Repository, bevor du Gewichte oder Ergebnisse kommerziell einsetzt.

Wie entstehen die transparenten Bilder?

Transparenz steckt im Autoencoder: ein 64-Kanal-RGBA-VAE mit 16-facher räumlicher Kompression. Du forderst sie im Prompt an, indem du ein RGBA-Bild mit transparentem Hintergrund beschreibst – zurück kommt ein echter Alphakanal statt einer Freistellmaske.

Welche Hardware brauche ich?

Es ist ein 7B-Generierungsmodell mit einem 8B-Textencoder, praktisch brauchst du also eine moderne GPU mit ausreichend VRAM. Die Community-Runtimes helfen: vLLM-Omni und SGLang bieten FP8-Gewichte, CPU-Offloading und Multi-GPU-Parallelität, LightX2V zielt auf Consumer-Karten.

Wie viele Referenzbilder sind möglich?

Bis zu zehn in einer Bearbeitung. Genau das macht Kompositionen mit mehreren Motiven praktikabel: mehrere Personen in einem Bild oder ein Outfit aus einzelnen Produktfotos, wobei jedes Motiv erkennbar bleibt.

Die Qwen-Image-Familie auf GoEnhance testen

Qwen-Image-2.1 ist offen und läuft auf eigener Hardware. Wenn du lieber einen Prompt schreibst und ein Bild zurückbekommst, öffne Qwen Image 3 auf GoEnhance und starte mit einem der Beispiele oben.

Mit Qwen Image 3 starten