AI人物動画生成ツール
より柔軟に人物主体の動画を作成
撮影不要で人物主体のシーンを制作
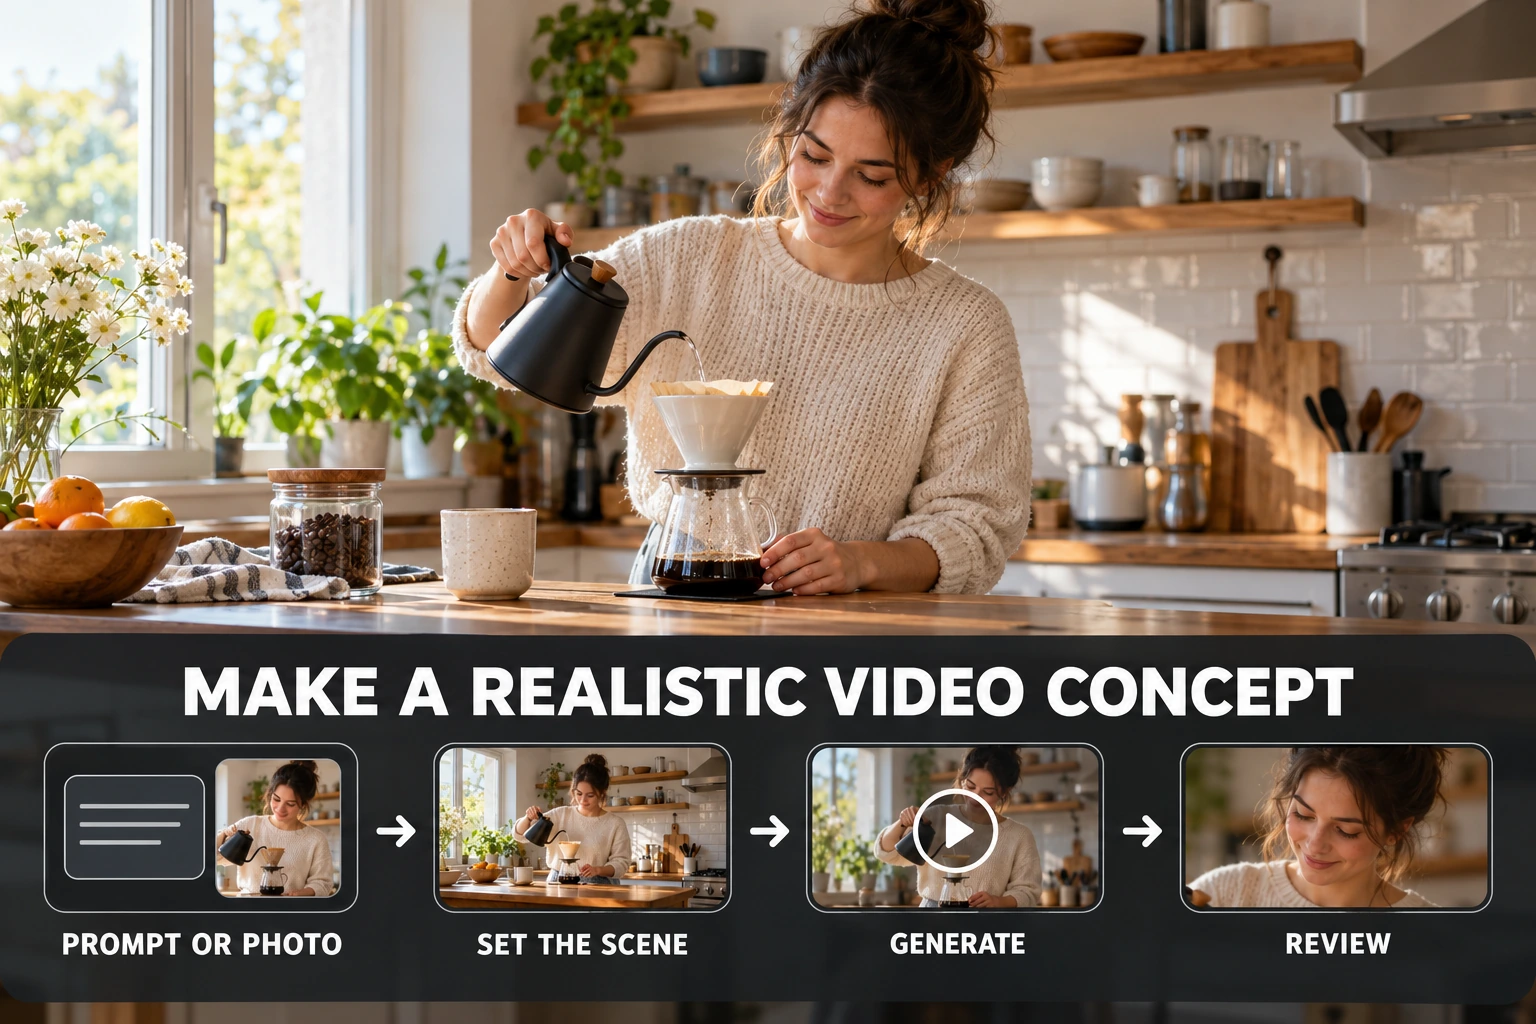
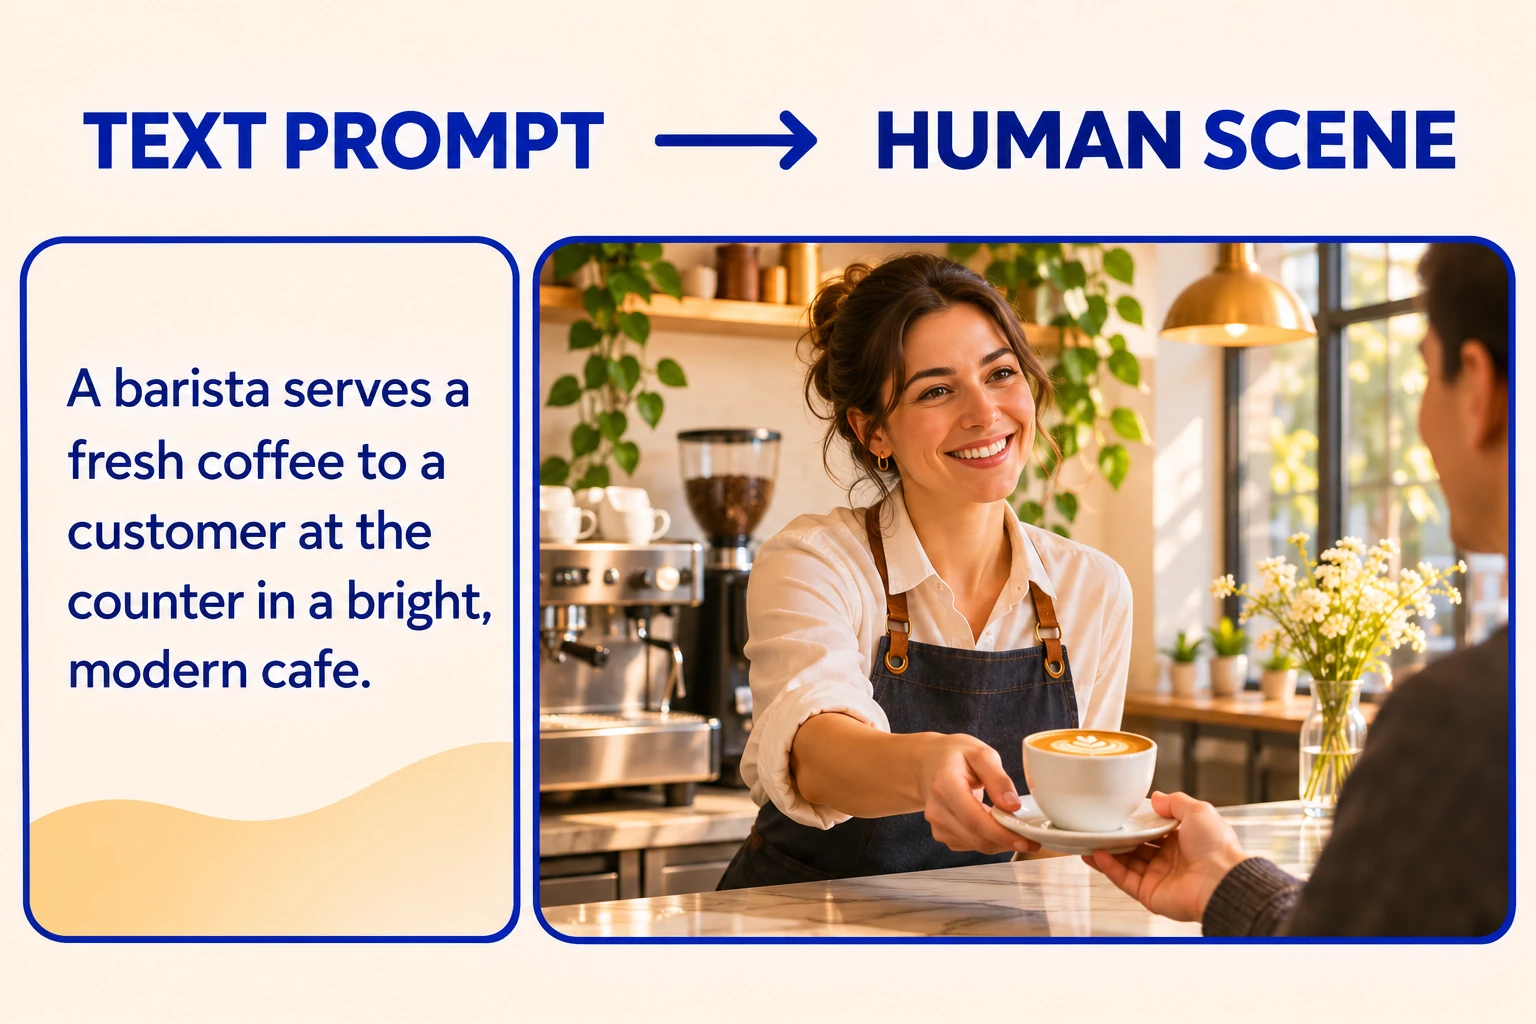
実写撮影やロケ地の手配をすることなく、人物主体の動画コンセプトを作成できます。ゴーエンハンスのテキストから動画への生成機能は、プロンプト、スクリプト、または概要を受け付け、新しい環境にいるプレゼンター、明確なアクションを行うキャラクター、あるいはショートストーリーのシーンなどに柔軟な出発点を提供します。これにより、チームは撮影、出演者、セットに時間を費やす前に、人物を中心としたアイデアを検討できます。生成される結果はテキストの指示に基づいたコンセプトであり、このページの画像は出力サンプルではなくイメージ例です。テキスト動画生成AIのワークフローが、このテキスト主導のアプローチをサポートします。
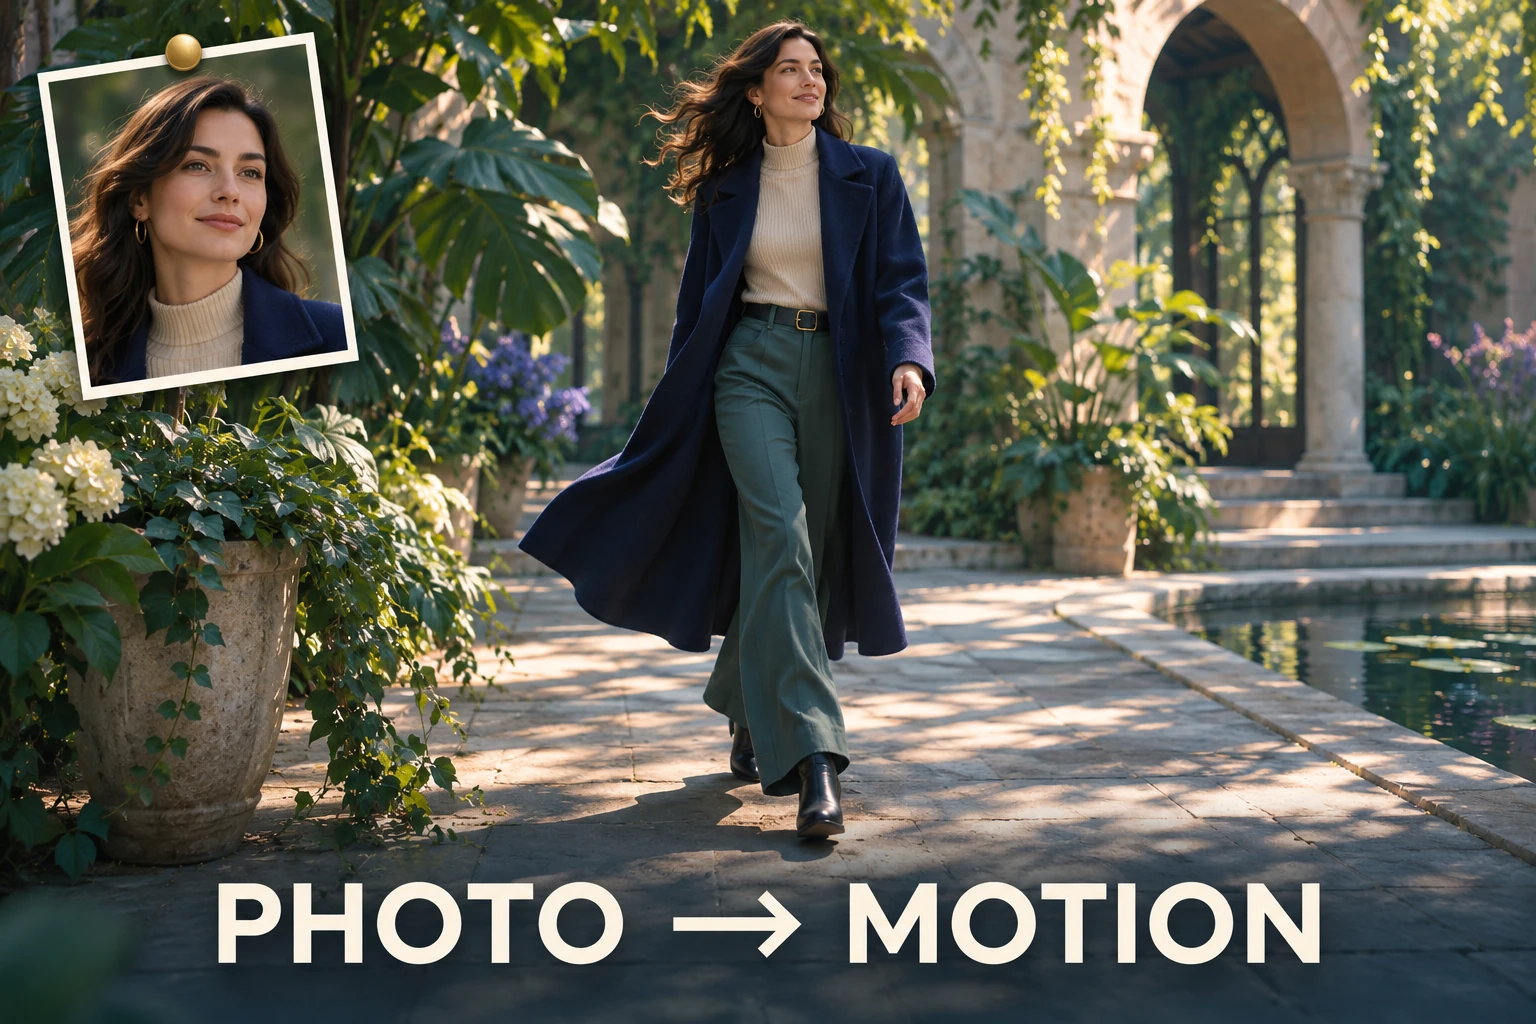
シーンが変わっても認識しやすいキャラクターを維持
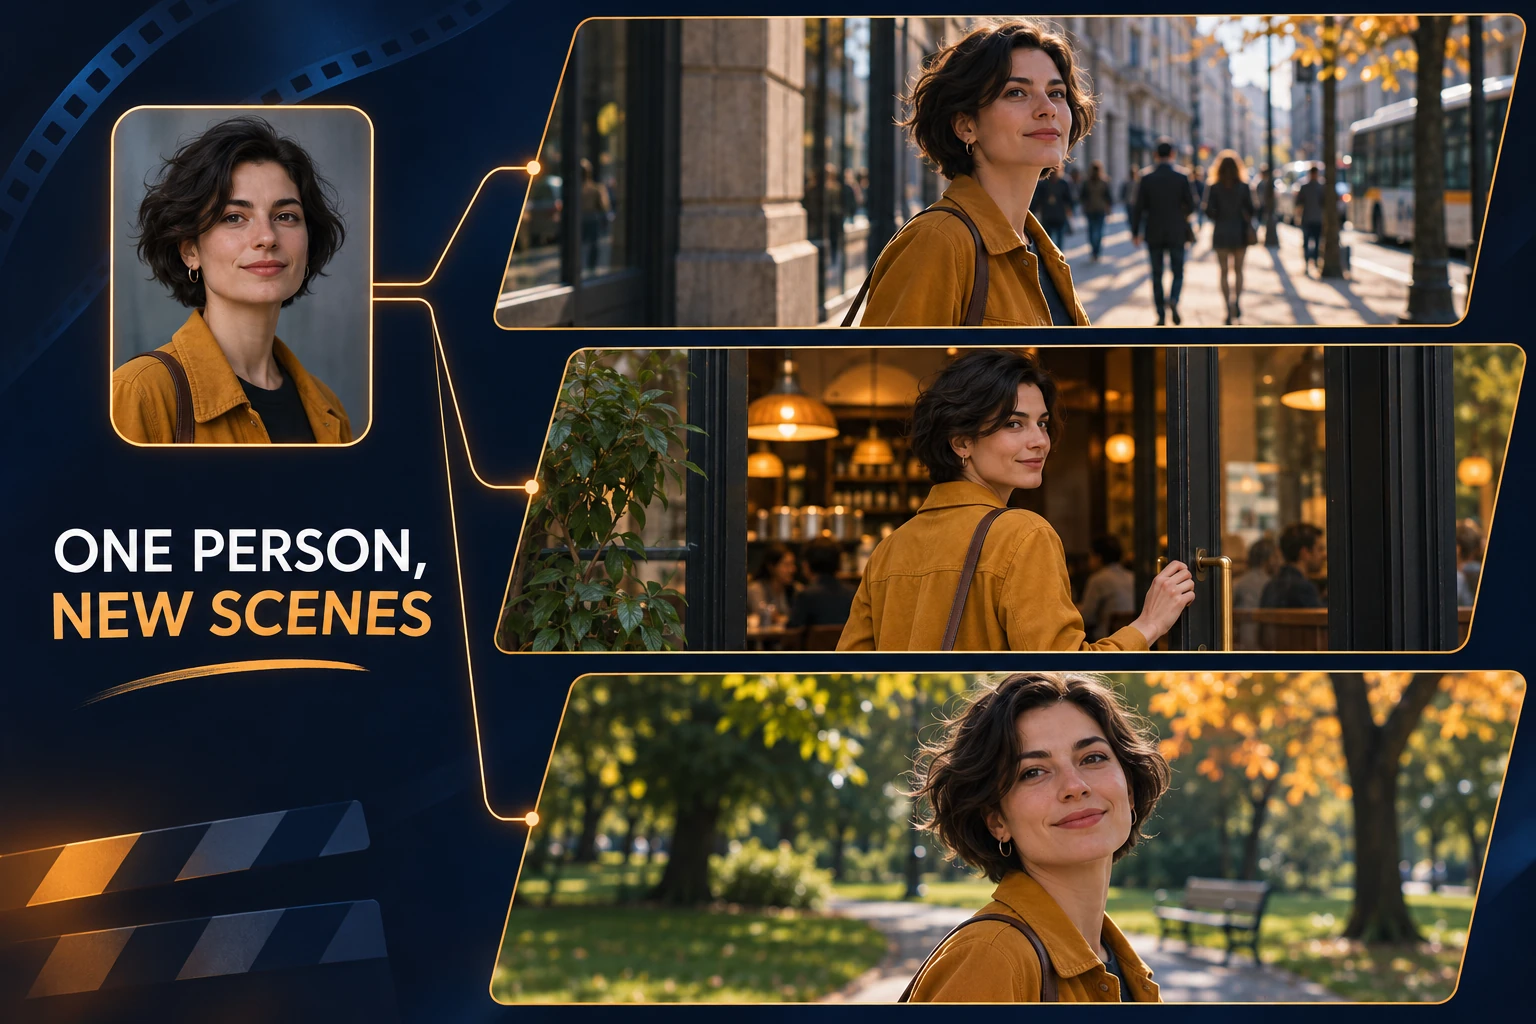
1〜4枚の参照画像を使用することで、ゴーエンハンスの独立したキャラクター一貫性ワークフローにおいて、異なるシチュエーションでも同一人物を描き出す視覚的基盤を構築できます。これにより、ショートストーリーやSNS向けシリーズ動画でキャラクターが再登場した際のつながりを強化しつつ、新しいアクションやシーンを展開する余地を残せます。この手法は、テキストの説明だけでキャラクターを一から再構築するよりも優れていますが、すべてのフレームで完全に同一の特徴を保証するものではありません。一貫性が最も重要視されるプロジェクト向けに、専用のキャラクター一貫性動画AIワークフローがそのニーズに対応します。
AI人物動画の生成方法
テキストまたは画像を選択
新しいシーンのプロンプトを入力するか、人物やキャラクターの参照素材が既にある場合は画像から開始します。同一の被写体を継続して登場させたい場合は、専用のキャラクター一貫性ワークフローを開き、参照画像を追加してください。
1つの明確なアクションを指定
人物の外見的特徴、状況設定、動作、カメラのアングルを指定します。モデルが意図を正確に解釈できるよう、動きはシンプルで明確なものに絞ってください。
シーンを生成して確認
人物の外見、動き、構図、背景を確認します。細部にズレが生じる場合は、アクションをシンプルにするか、元画像やプロンプトをより具体的にしてください。